正在加载…
它能帮你做什么
它支持七个平台:小红书、抖音、快手、B 站、微博、百度贴吧、知乎。七个平台的能力是一套,我按你会用到的顺序说。
第一,按关键词采。 你在设置里填一个词,比如「露营」「考研」「AI 副业」,它把搜索结果里的笔记和视频一条条采下来,标题、正文、点赞数、收藏数、评论数都有。
第二,按指定内容采。 手上已经有几条想细看的笔记或视频,把它们的编号填进去,它只采这几条,不用跑一遍搜索。
第三,采评论,连楼中楼一起。 一级评论全部拉下来,评论底下的回复也能一起采。这是它最有价值的一块。做选题、做用户调研、看一个话题的真实反应,评论比正文有用得多。采完还能直接生成词云图,高频词扫一眼就知道大家在聊什么。
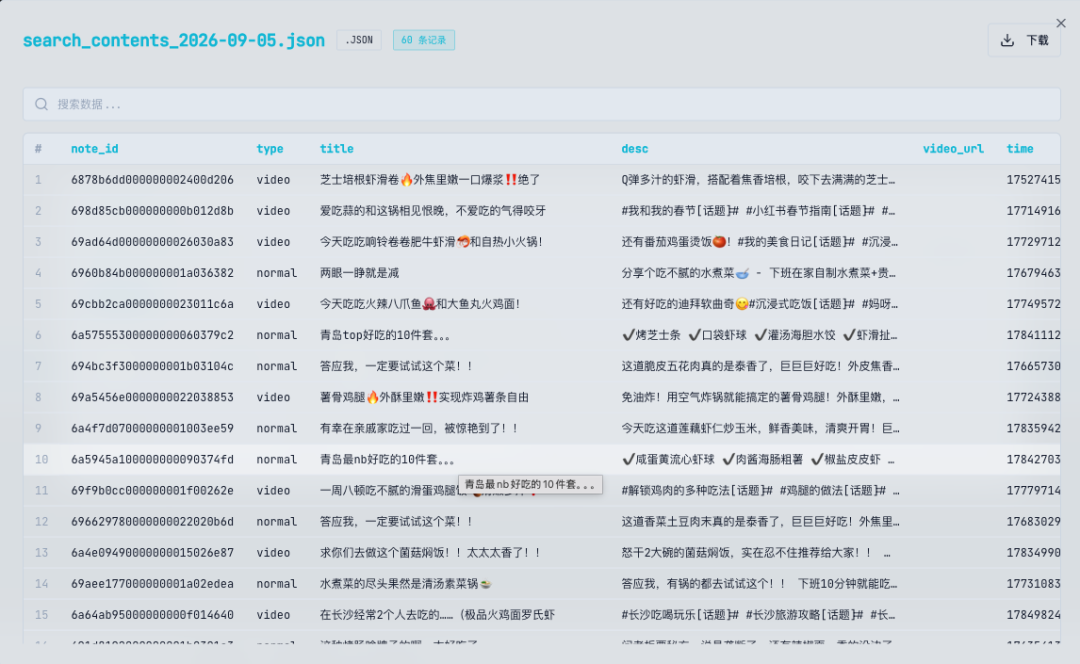
第四,盯一个创作者。 填一个作者的主页,他发过的内容列表和对应数据都能拿到。想研究同赛道做得好的账号,这一招直接。
采下来的数据可以存成 Excel、CSV、JSON,也能直接写进数据库。存成 Excel 最省事,打开就能看,再丢给 CodeX 让它帮你分析。
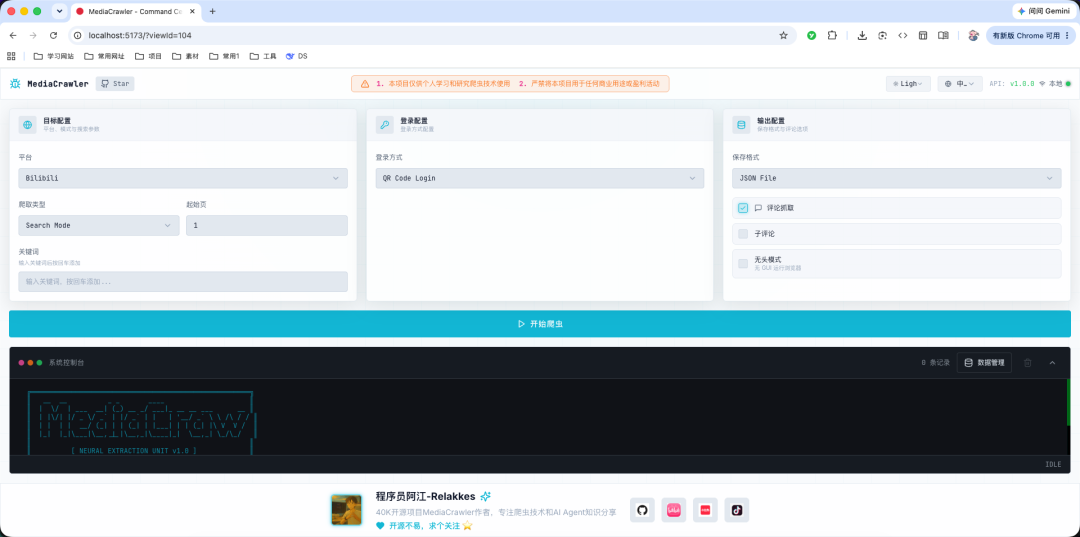
它还有一个网页版的操作界面。选平台、填关键词、勾选要不要采评论、选保存格式,都在浏览器里点,看着日志跑,跑完直接预览数据。 不想碰任何技术细节的同学,就用这个界面。
为什么这类工具里它最省心
这类工具以前最大的麻烦是「签名」。平台把接口参数加了密,工具想直接调接口,就得先把平台的算法破解出来。平台隔三差五改一次算法,工具立刻失效,作者跟着修,修不过来项目就死了。这几年死掉的抓取工具,大多是这么死的。
MediaCrawler 的思路不一样:它不破解加密,而是用一个真实的浏览器替你去操作。 你先用手机 App 扫码登录一次,登录状态存在本地,之后需要签名的地方,让浏览器在登录状态里自己算。平台改算法它不受影响,因为签名从来不是它算的,是浏览器算的。
默认还会连上你电脑上天天在用的那个 Chrome,复用你已经登录的账号和 Cookie,平台看到的就是一个正常用户在刷网页。这也是它从 2023 年 6 月开源到现在一直能用的原因。
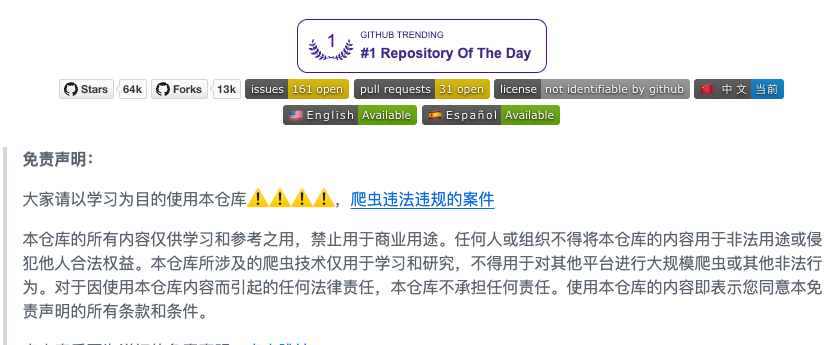
作者是「程序员阿江」,一个人维护。有一段插曲值得说:这个项目火了以后,作者担心惹麻烦,一度把仓库删了。后来发现有人把代码拿去卖钱,他索性补了一份免责声明重新开源,现在项目首页第一屏就是加粗的免责条款。这份声明不是走形式,后面红线那一段会讲到它。
如果你看过社区里另一篇精选《这个 Skill,打造你自己的新闻台》,那篇讲的 NewsCrawler 也是这位作者的项目,一条线抓新闻和文章正文,一条线抓社交平台的笔记和评论。
看到这儿,后面是学员专属
后面这一半是训练营学员的内容。你要是学员,用手机号登录就能接着往下看。