正在加载…
它解决的是哪一步
你让 AI 去读一篇网上的文章,通常发生的事是这样的:它打开浏览器,把整张网页连菜单、广告、评论、推荐阅读一起吞进去,再从里面猜哪块是正文。一篇文章,光是「读进来」这一步就要吃掉几万字的上下文,真正的正文可能只占三十分之一。 钱花在噪音上,还容易读歪。
NewsCrawler 干的事很朴素:它认得这 12 家平台的网页结构,直接把正文、图片、作者、发布时间剪出来,整理成一份干净的 Markdown 或者一张结构化的表,交给 AI。 AI 拿到的只有该看的东西,上下文留给总结、比较和判断。
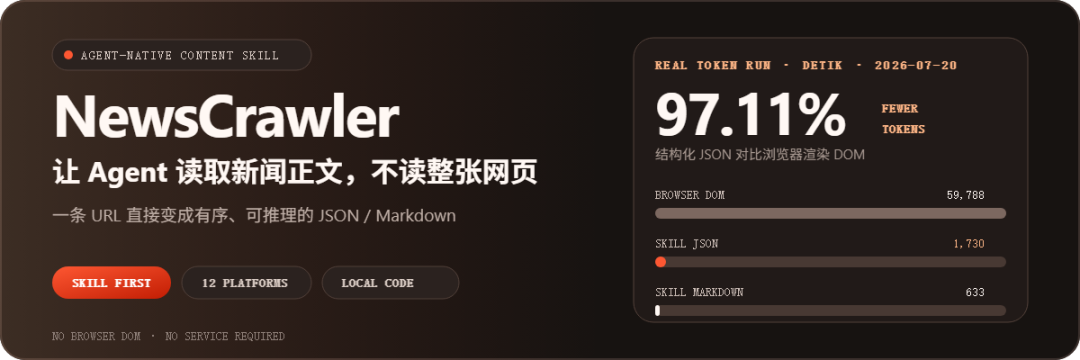
上面这张图是作者 7 月 20 日用一篇印尼新闻做的对照:同一篇文章,浏览器整页读进去将近六万个 token,用这个 Skill 抽出来的结构化数据一千七百多,Markdown 只有六百多。少掉的那 97%,全是网页噪音。 这只是一篇文章的样本,不同网页会有出入,但量级是这样。
它能读哪 12 家
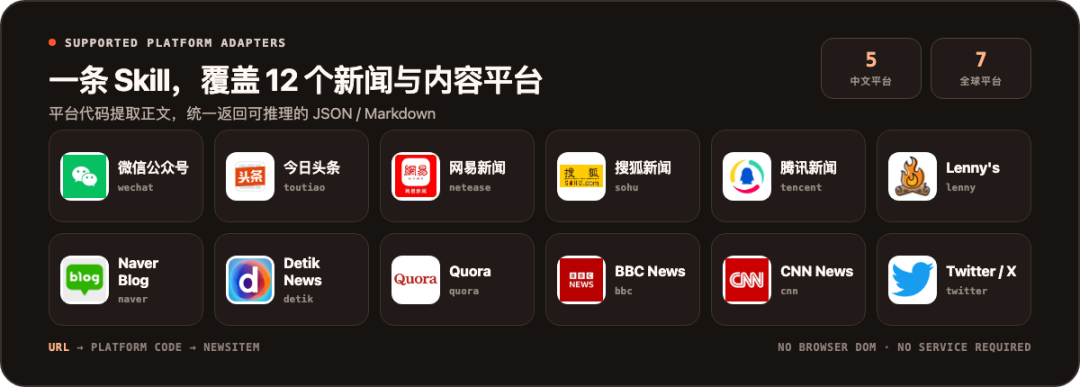
中文平台五家:微信公众号、今日头条、网易新闻、搜狐新闻、腾讯新闻。 海外七家:BBC、CNN、Twitter/X、Lenny's Newsletter、Quora,还有韩国的 Naver Blog 和印尼的 Detik News。
对咱们大多数同学来说,最有用的就是第一个:微信公众号。 公众号文章有防盗链、有各种奇怪的排版,一直是最难让 AI 顺利读进来的一类内容。它专门做了适配,作者 8 月 8 日的最后一次提交,就是在修公众号文章抓取的一个问题。
作者是谁,靠不靠谱
作者叫 NanmiCoder。你可能没听过这个名字,但他另一个项目 MediaCrawler 在 GitHub 上有六万四千多个 Star,是国内做社媒内容抓取最常被提到的开源项目之一。MediaCrawler 抓的是小红书、抖音这类平台的笔记和评论,NewsCrawler 是他另开的一条线,专门抓新闻和文章正文。
NewsCrawler 本身 2024 年 11 月开源,现在 592 个 Star,规模比 MediaCrawler 小得多,也还没有正式的版本号。它还年轻,不是每个平台都打磨到位,但作者一直在维护,最近一次更新就在一个月前。
看到这儿,后面是学员专属
后面这一半是训练营学员的内容。你要是学员,用手机号登录就能接着往下看。