正在加载…
新模型 GPT-6.1 Sol:接近最强,价格五分之一
先认一下人。OpenAI 现在的 GPT-6 家族有三个型号:Astra 最聪明也最贵,Sol 居中,Luna 最快最便宜。
这次升级的是中间那个,新名字叫 GPT-6.1 Sol。OpenAI 给它的定位就一句话:智力接近 Astra,价格只有 Astra 的五分之一。
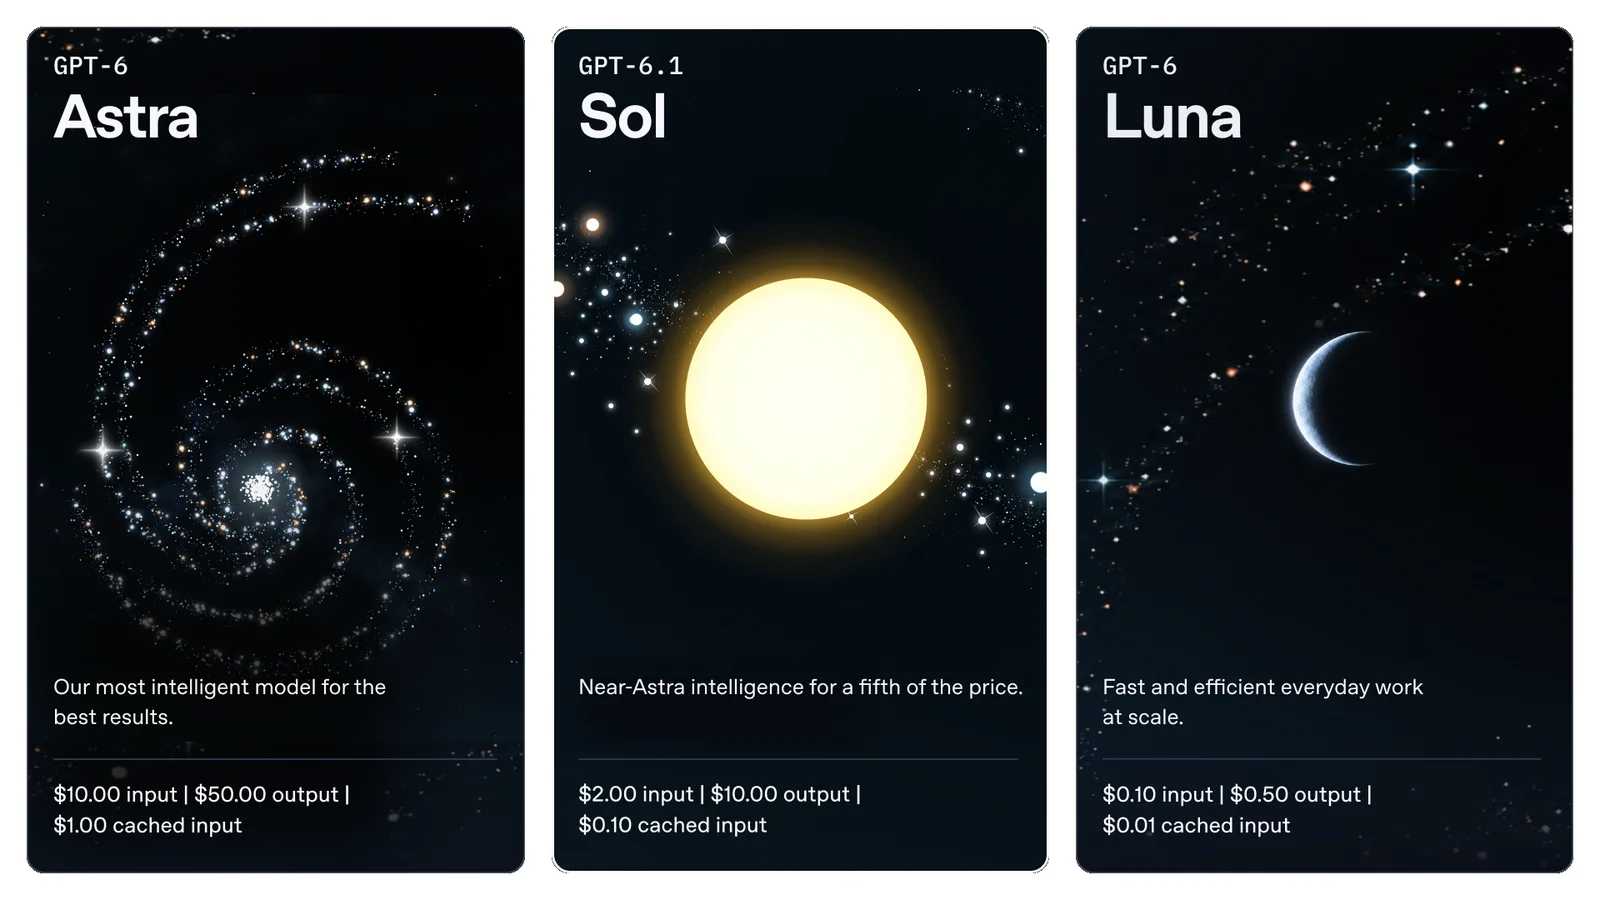
图上的价格是给开发者按量计费用的,每一百万 token(可以粗略理解成字数)的单价:Astra 输入 10 美元、输出 50 美元,Sol 输入 2 美元、输出 10 美元,正好五分之一。
咱们大多数同学用的是订阅套餐,不直接按这个价付钱。但道理是相通的:模型越便宜,同样的套餐额度就越经用。以前干到一半提示额度用完的同学,对这一点应该有体会。
「接近 Astra」这个说法也不只是官方自己讲。在第三方的独立综合榜单上,Sol 拿了 52 分,Astra 是 53 分,Sol 每个任务的成本大约是 Astra 的 22%。顺带说一句,这个榜单目前排第一的是 Anthropic 的 Opus 5.5,58 分。所以 Sol 的卖点很清楚,它拼的是性价比,不是第一名。
还有两个数字我觉得值得知道,都是 OpenAI 公布的:
- 专挑容易答错的难题来考,Sol 在最高推理档下,回答里含事实错误的比例是 4.1%,Astra 是 4.0%,几乎持平。
- 搜索工具坏了的时候,模型应该老实告诉你「我没查到」,而不是编一个答案。没说实话的比例,Sol 是 2.1%,上一代 Sol 是 4.9%,Astra 是 1.5%,最便宜的 Luna 高达 28.7%。
第二条对咱们很实用。图便宜选 Luna 干查资料的活,要格外留心它编答案,重要的事实自己再核一遍。
你现在能不能用上
能。GPT-6.1 Sol 已经开放在 CodeX 和 ChatGPT 工作里,Plus、Pro、Business、Enterprise、Edu 这几种套餐都有。
有一点要注意:它目前还没进普通的聊天窗口。你在 ChatGPT 聊天里的模型列表找不到它是正常的,打开 CodeX 桌面版,在模型选择那里看。如果没看到,先把 CodeX 更新到最新版本。
推理档位不是越高越好
这是整篇里我最想让你记住的一段。
CodeX 里选模型的时候,旁边还有一个「推理强度」可以调,从低到高好几档。很多同学的习惯是:反正都花钱了,直接拉到最高,想得越久肯定越好。
OpenAI 这次公布的一组数据,说的恰恰相反。这组数据来自一个叫 DeepSWE 的评测,考的是在真实的代码项目里干活:
- GPT-6.1 Sol 开「中」档:每个任务花 0.42 美元,得分 73.0%
- GPT-6.1 Sol 开「高」档:每个任务花 0.65 美元,得分 75.2%
- GPT-6.1 Sol 开 Max:每个任务花 1.57 美元,得分 71.9%
- GPT-6 Astra 开「中」档:每个任务花 3.08 美元,得分 72.8%
- GPT-6 Astra 开「超高」档:每个任务花 4.43 美元,得分 74.1%
- GPT-6 Astra 开 Max:每个任务花 7.50 美元,得分 73.2%
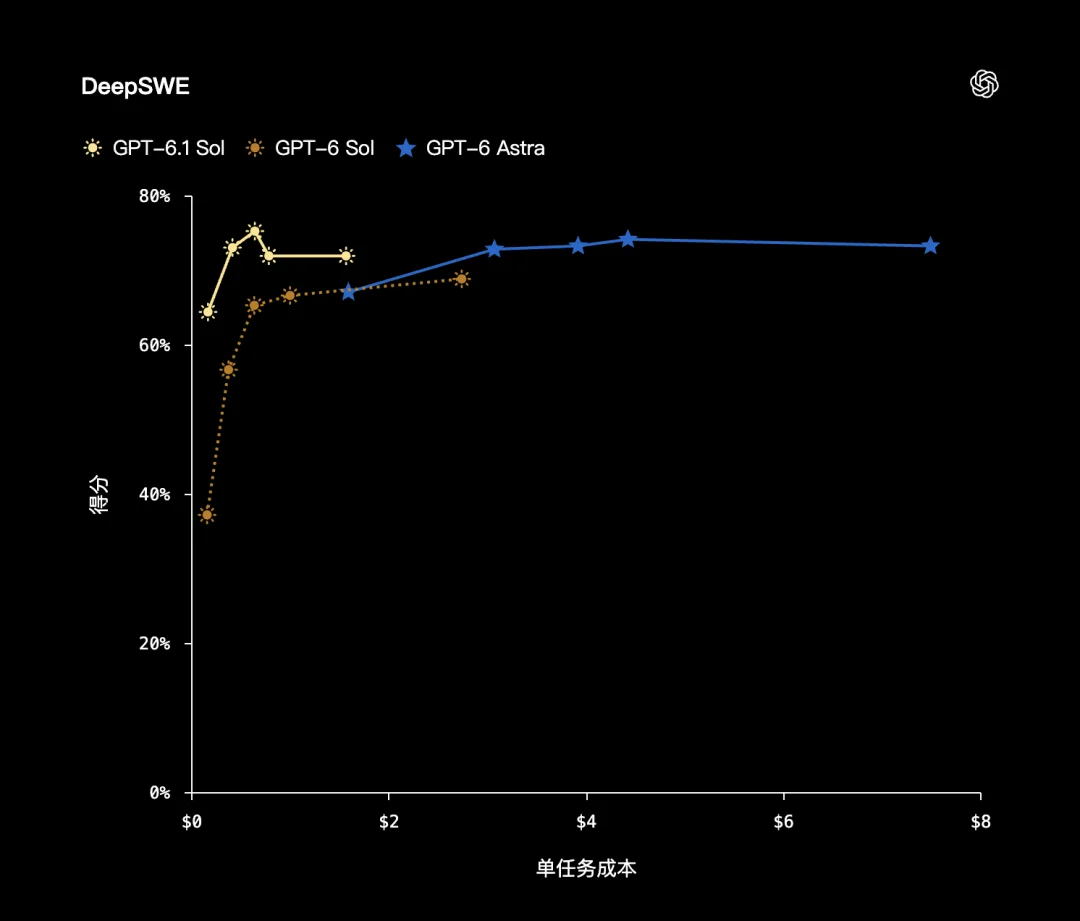
看图更直观。黄线是新 Sol,它在很靠左(很便宜)的位置就冲到了最高点,再往右走,钱花得更多,线反而往下掉了。
翻成大白话是两个结论:
第一,Sol 的最好成绩出现在「高」档,不是 Max。从「高」开到 Max,成本翻了一倍多,分数反而掉了 3 个多点。Astra 也一样,Max 比「超高」更贵,分数更低。
第二,Sol 开「中」档,就已经略高于 Astra 的「中」档,而花的钱只有它的七分之一左右。
为什么想得更久反而更差?一个容易理解的类比:一道本来会做的题,反复琢磨半小时,有时候会把对的答案改错。模型也会想过头。
所以建议很简单:日常的活先用 Sol 的「中」档,觉得不够好再拨到「高」,别默认开到最大。只有那种真的很难、反复做不对的活,再换 Astra 试试。之前讲 Sonnet 5.5 那篇每日精选里我说过同样的话,这次是 OpenAI 自己的数据又印证了一遍。
要提醒的是,这组分数考的是写代码。咱们平时整理知识库、写文案、做工作台,情况不一定一模一样。最靠谱的办法是拿你自己常干的一件活,两个档位各跑一次,自己比。
看到这儿,后面是学员专属
后面这一半是训练营学员的内容。你要是学员,用手机号登录就能接着往下看。