正在加载…
先有一张靶子,AI 才知道往哪儿改
平时我们让 AI 做画面,是用文字描述:「暗色调、有质感、像游戏那样」。这些话 AI 能听懂个大概,可它做完没法判断自己离你要的还差多远,因为目标只存在于文字里,没法拿来比对。
dream-loop 把这一步换掉了。它让 AI 先用生图功能,把你要的东西直接「梦」成一张高质量的成品截图,存下来当靶子。作者特别叮嘱,这张图不能是概念图、宣传海报那种艺术加工过的画,得是一张就像真的做出来以后截下来的屏幕截图,因为接下来要照着它一个像素一个像素地追。
有了靶子,后面就是一个闭环:
- AI 照着目标图动手做。
- 做完截一张实际效果图。
- 另派一个 AI 当评委,把实际截图和目标图摆在一起比,挑出哪里不像。
- 回去按评委的意见改,改完再截图、再比,直到评委满意。
如果做着做着发现当前效果已经不错了,还可以回到第一步,照着现在的样子再「梦」一张更好的目标图,往上再够一够。
评委是怎么打分的
这个 Skill 里最值得看的是评委那一段。评委每一轮都是一个全新的 AI,不带之前的记忆,这样它不会因为跟干活的那位「混熟了」就手下留情。
它按四项打分,满分 10 分:构图 3 分、光影 3 分、材质 3 分、细节 1 分。构图看镜头角度、东西摆的位置和大小对不对;光影看颜色、明暗、阴影、反光;材质看每个表面像不像,石头是不是像塑料、地面够不够湿;细节就是拿放大镜一处处找不一样。
作者给评委的要求很严:挑的毛病必须具体到别人拿着清单就能去改。不许只说「这棵树看着假」,得说清楚是哪里让它显得假、该怎么改。总分到 8 分才算过关;要是连续两轮都卡在同一个问题上涨不动,它不会继续小修小补,而是退一步把整个做法推倒重想。
我觉得这一段值得每个同学记住,跟用什么模型无关:让 AI 改东西,别只说「再好看点」,要给它一个能对照的样子,再让它说出具体差在哪。
作者做的那个演示
作者只给了 CodeX 一段话,大意是:做一个在浏览器里跑的图形演示,斜上方俯视的视角,方块堆出来的画风但光影要真实,地面是湿的、能反光,奇幻题材,有一个角色在场景里;点哪儿人就走到哪儿,拖动转镜头,滚轮缩放;世界要有生气,有动画、有环境里的小动静;限时 1 小时,别下载现成素材,不用问我,直接做。
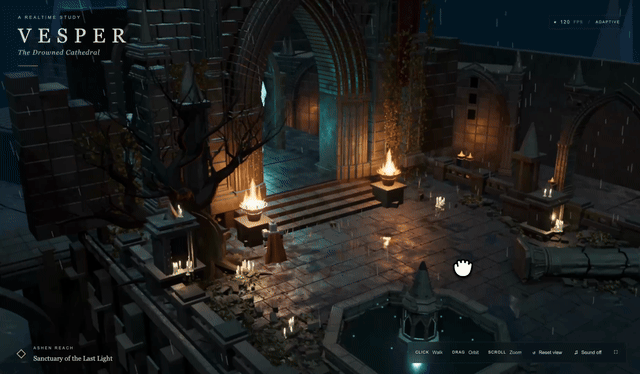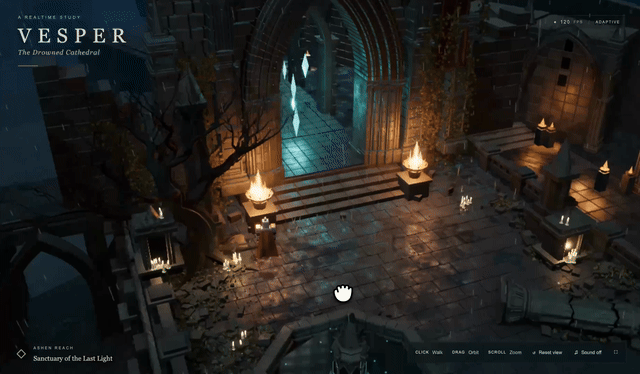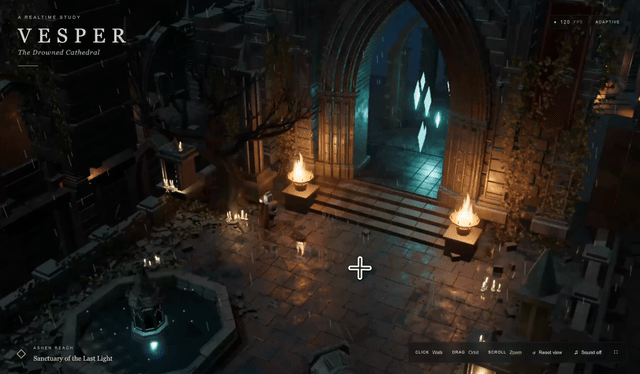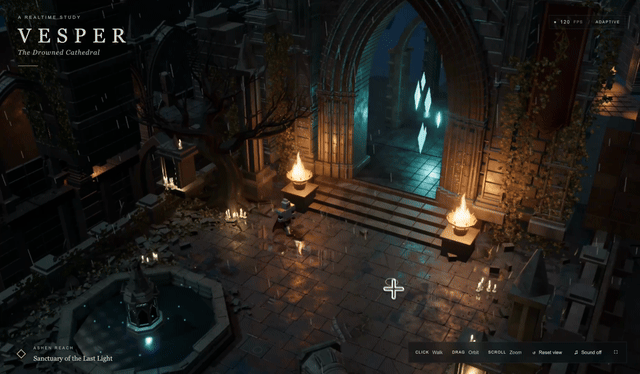
用的是 CodeX 里的 GPT-6 Astra,开的高推理强度。做出来就是上面那张动图里的「Vesper」,一座雨里的破旧大教堂,火盆的光映在积水上。作者还把它放到了网上,电脑浏览器打开就能自己点着走两步:https://dream-loop-demo.anshu.dev
看到这儿,后面是学员专属
后面这一半是训练营学员的内容。你要是学员,用手机号登录就能接着往下看。