正在加载…
转出来的不是摘要,是一个能查的结构
先把这件事说清楚,因为它跟我们平时说的读书笔记、AI 总结不是一回事。
一本书喂给它,跑完之后你得到的是一个文件夹,里面有这几样:
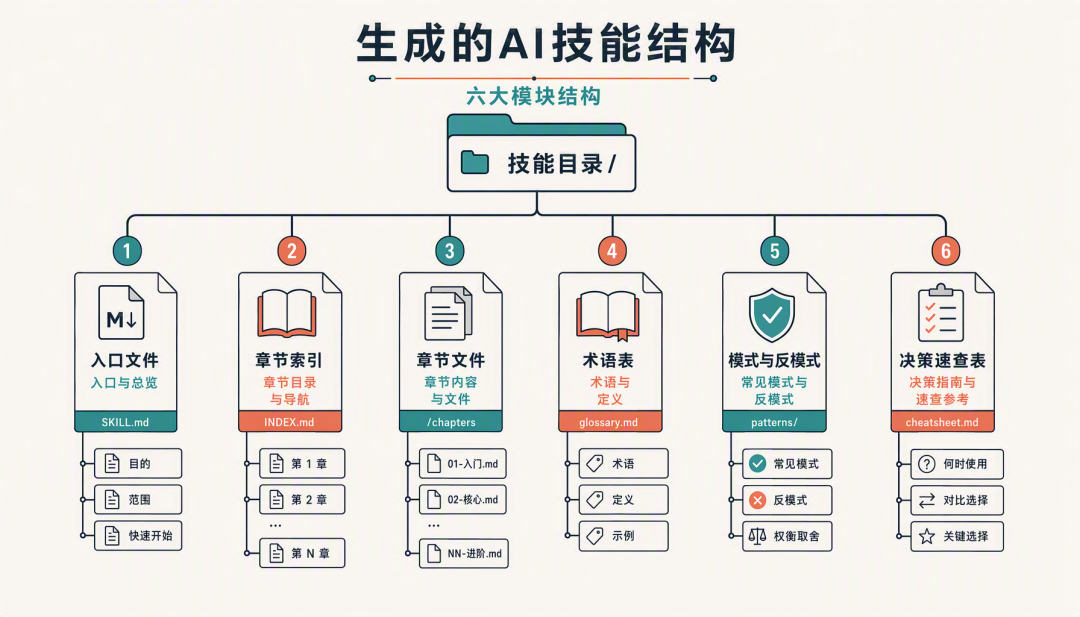
一个入口文件,大概四千 token,装的是这本书最核心的思维模型,加一份章节索引;一章一个文件,每个一千 token 上下,平时不加载,问到才打开;再加一份术语表、一份模式与反模式、一张决策速查表。
它做的是提炼,不是复制。项目规范里明确写了不许照抄原文段落,生成的是结构化的笔记,是这本书的框架、判断规则和踩坑清单。
为什么省:AI 只打开它需要的那一章
用起来是这样的。假设你转了一本讲数据系统的书,想问「复制」这个话题,就敲一句 /这本书 复制。AI 先读入口文件里的索引,发现复制是第五章,然后只把第五章加载进来,基于书里的内容回答你。
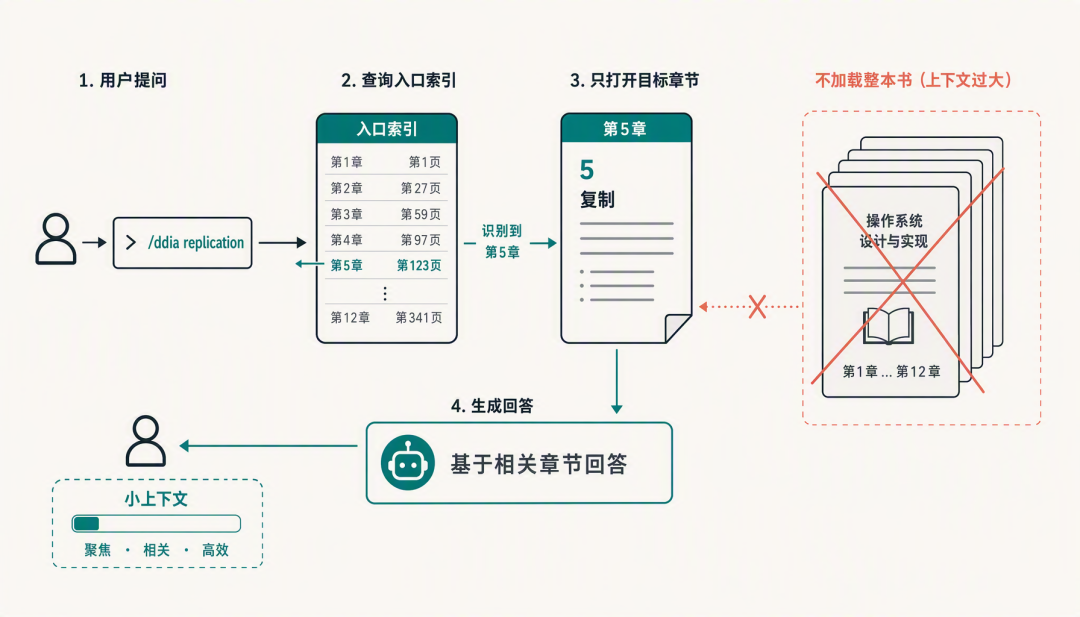
整个过程里,那本书的全文不会塞进对话。实际占上下文的只有入口文件加当前这一章,加起来约五千 token。作为对比,把整本书塞进对话问同一个问题,按书的大小要烧十几万到二十几万 token,而且下次再问还得重新烧一遍。
作者拿真实的书测过:一本 244 页的小书省 24 倍,一本 371 页的中等书省 35 倍,一本大部头省 51 倍。书越厚,省得越多。
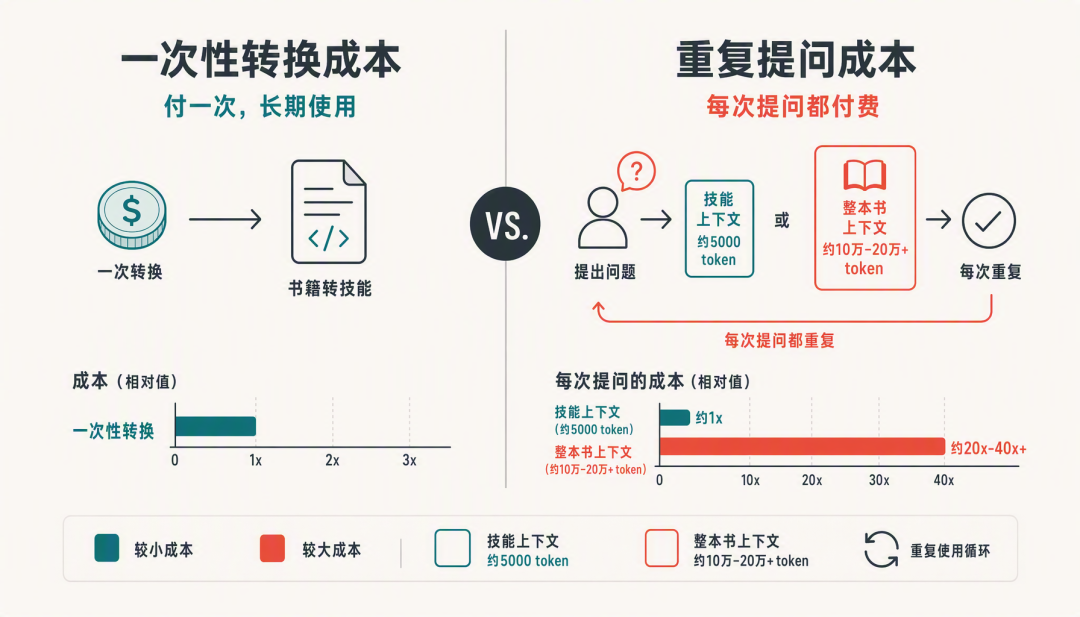
转换本身要花钱,因为是 AI 在读文本、写技能。作者按 Claude Sonnet 4.5 的价格估算:244 页的《Think Python 2》八毛八美元,371 页的《Working Backwards》九毛六,501 页的《Pro Git》一块二。大概一美元一本,只付这一次。 之后每次查都是几千 token 的事,同一本书多问几次,省下的就超过转换费了。
技术书和文字书,它分开处理
这个细节我觉得做得挺用心。开始转之前它会问你:这是技术书,还是文字为主的书?因为两条路用的解析工具不一样。
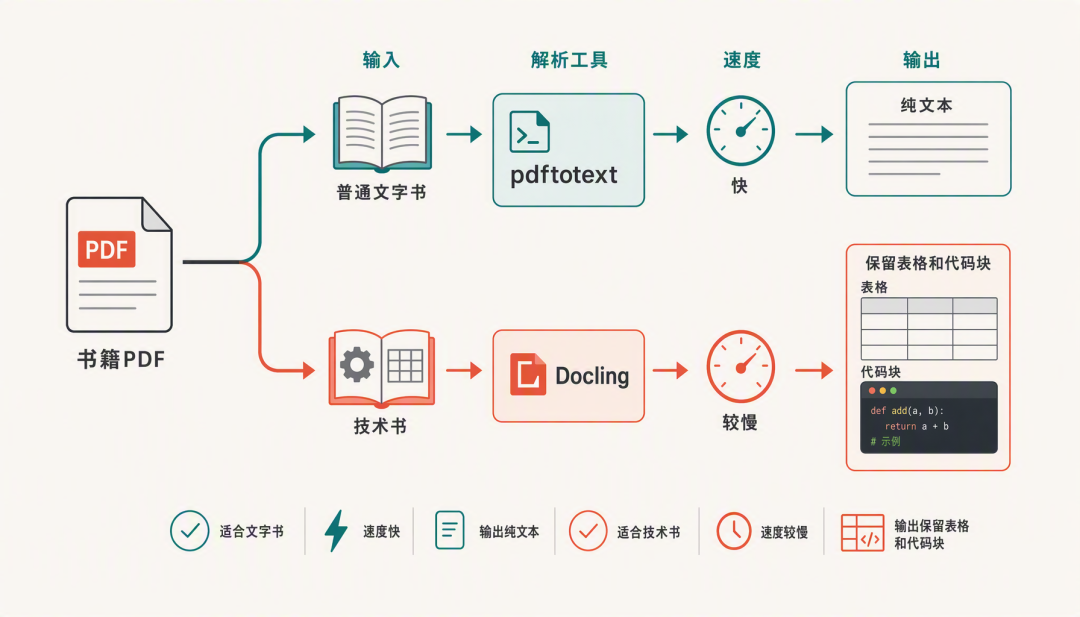
文字书走 pdftotext,几秒钟跑完。技术书走一个叫 Docling 的工具,慢一些,一页一两秒,但表格和代码块能原样保留成 Markdown。作者拿一本 103 页的技术 PDF 对比过:快的那条路 0.1 秒就完了,可书里 48 张表和 36 个代码块一个都没留下,出来的是一大段纯文字;慢的那条路花了 164 秒,表和代码全在。技术书丢了表格和代码基本就没法看,所以这个分叉值得。
转之前可以先跑一句检查命令,它会把你机器上缺哪个解析工具、该装什么都列出来,省得跑到一半才发现少东西。
看到这儿,后面是学员专属
后面这一半是训练营学员的内容。你要是学员,用手机号登录就能接着往下看。