正在加载…
← 每日精选
工具上新2026年8月25日
苹果出全新 Mac mini 和 Mac Studio 了,AI 时代为什么很多人想配一台
昨晚苹果更新了 Mac mini 和 Mac Studio,Mac mini 每一档都涨了 2500 元。比涨价更值得注意的是苹果换了说法,官网现在把它写成「部署 AI 代理的理想常开式台式机」。这篇讲清楚为什么越来越多人想在家放一台一直开着的机器、这次到底改了什么、涨价是怎么回事,以及什么人该买什么人先别买。里面有一条选配建议要特别看一眼,内存 24G 是基本盘,硬盘反而可以省。
写在前面
大家好,我是宋超。
我自己配置了一台 Mac mini,原因很具体。我有不少任务希望它能一直跑着,但在 CodeX 里如果一直跑任务,我的电脑就得一直开着。而我经常要通勤上班或者出差,电脑总开着很不方便。所以我在家里配了一台 Mac mini,就是希望它能持续稳定运转。
在 AI 时代,我觉得这种需求会越来越多。笔记本虽然方便,但一个在本地能持续运转、长时间跑任务的 Mac 是非常必要的。
另外,现在有些人开始尝试本地部署大模型,毕竟云端大模型的 token 挺贵的。如果能用本地部署的大模型来处理一些基础任务,很多人其实更倾向于这么做。所以 Mac 在这两方面都能提供很大帮助。
昨天晚上苹果更新了 Mac mini 和 Mac Studio,正好借这个机会,把这件事跟大家说清楚。下面会讲这次到底改了什么、价格涨了多少、为什么涨,以及什么人该买、什么人先别急。
📌 内容出处:爱范儿 · 点这里看原文
先说说我家里那台 Mac mini 在干什么
我们第二周教知识库的时候,讲过一整套自动化。每天上午九点做一次摄入检查,把 Raw 文件夹里还没消化过的新素材读一遍,在 Wiki 里更新概念页面,在 log.md 里记一笔。每天晚上十点,把得到大脑里过去 24 小时新增的笔记搬进 Raw/00-inbox。每周日晚上八点,做一次归档、健康检查,再发一份知识库周报。
这套东西跑起来之后确实很省心。但那节课里我特意提过一个前提,原话是这样的。
如果你的知识库在本地电脑上,执行任务的时刻电脑得开着。云端 Hermes 去读写你本地的文件,本地电脑关机它就干不了活。
这个前提听着不起眼,落到日常里就是个天天要面对的麻烦。你设了一个早上九点的任务,可你九点在地铁上,笔记本在包里。你出差三天,机器合上了,这三天的自动化全都空转。
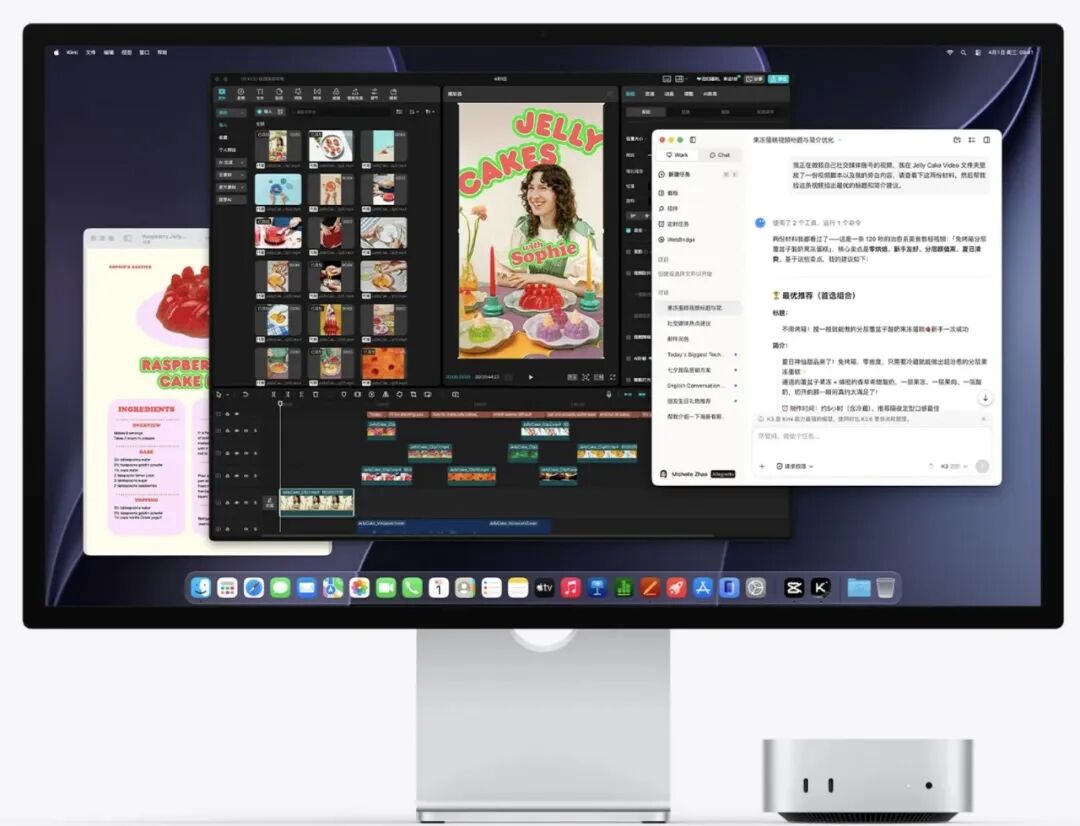
所以我在家里放了一台 Mac mini。它不当主力机,就一直插着电、连着网、开着放在那儿。我人在哪儿不重要,它该几点干活就几点干活。等我晚上回家打开电脑,东西已经在库里了。
这个用法说起来一点都不高级,本质上就是给自己配了一台永远不关机的机器。但它解决的是一个特别真实的问题。
有意思的是,苹果这次把这个用法写进了产品定义
这件事的顺序挺值得玩味。
一开始是用户自己琢磨出来的。今年上半年本地 Agent 部署火起来之后,很多人发现这类工具得有一台机器长期开着跑,于是 2024 年那款 M4 Mac mini 成了大家的首选。它便宜、省电、体积小,插在那儿几个月不用管。那会儿它已经是两年前的产品了,还是照样被抢。
苹果自己也注意到了。库克在五月的财报会上说过一句,这些设备是运行人工智能及智能代理工具的绝佳平台,客户对它们的认知速度快于苹果预期。
到这次更新,说法正式改了。苹果中文官网现在写的是,Mac mini 适合「智能体 AI 工作流」,是「部署 AI 代理的理想常开式台式机」。苹果官网介绍 M6 芯片的时候,除了视频剪辑、编译代码这些老例子,还专门加了一个新场景,智能体任务。
三月还是用户自己摸索出来的野路子,八月变成了厂商写在官网上的正经定义。这半年 AI 圈发生的很多事情,其实都是这个节奏。
这次到底改了什么
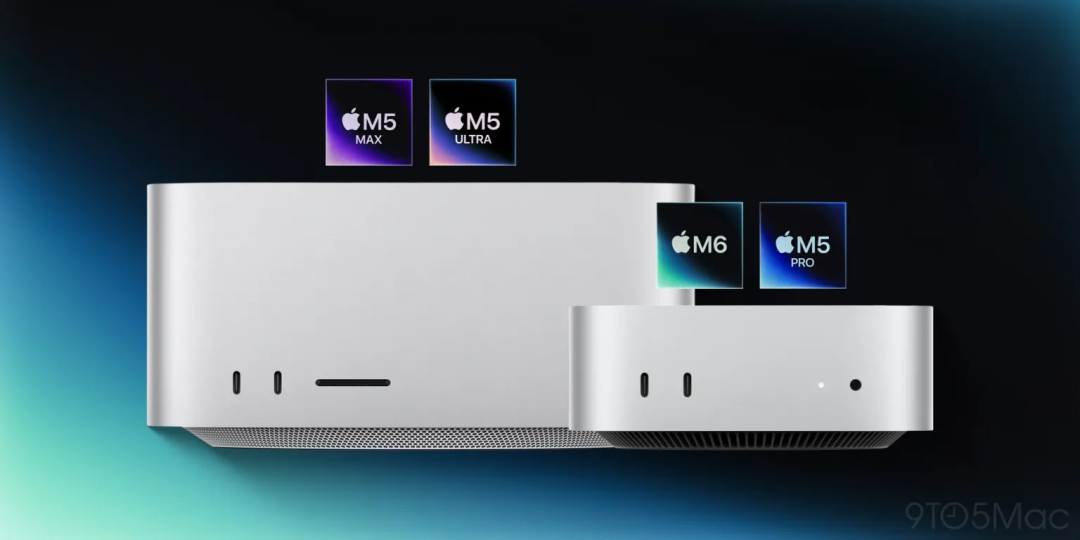
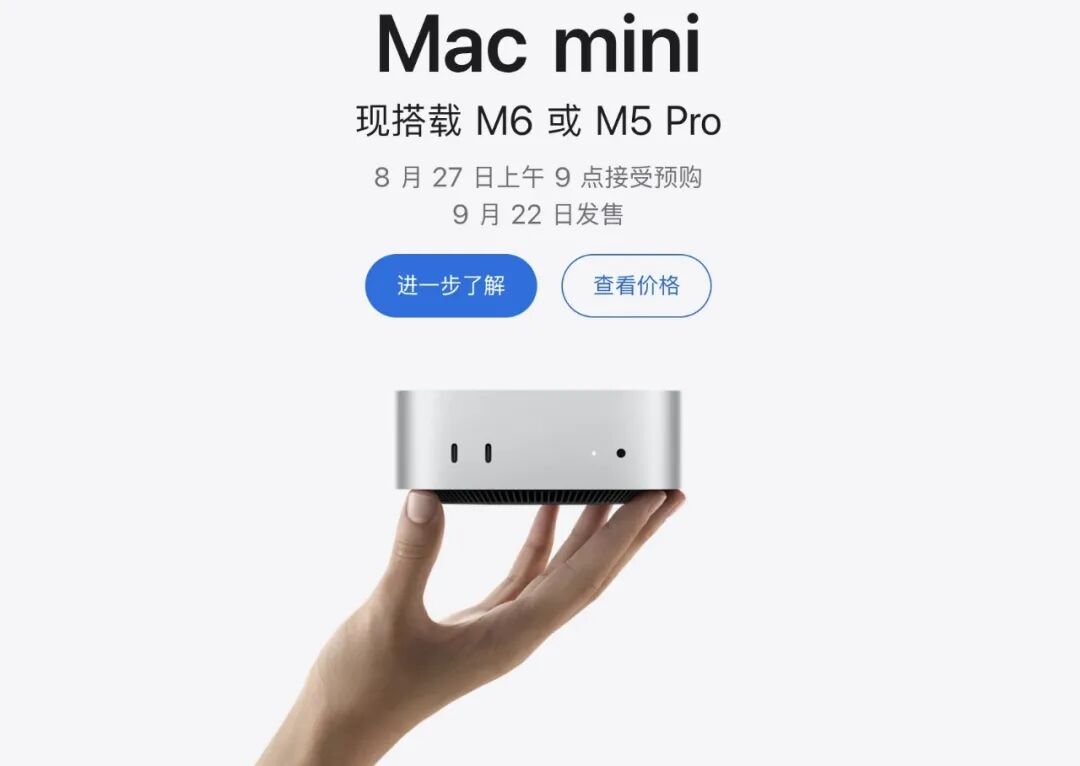
新款 Mac mini 有两个版本,一个用 M6,一个用今年三月就发布过的 M5 Pro,中间的标准版 M5 直接跳过了。定位更高的 Mac Studio 则是 M5 Max 和 M5 Ultra 两款。
国行 8 月 27 日上午 9 点开始预购,9 月 22 日发售,比美国晚两天。M5 Ultra 那个版本要等到 10 月下旬。
M6 这颗芯片
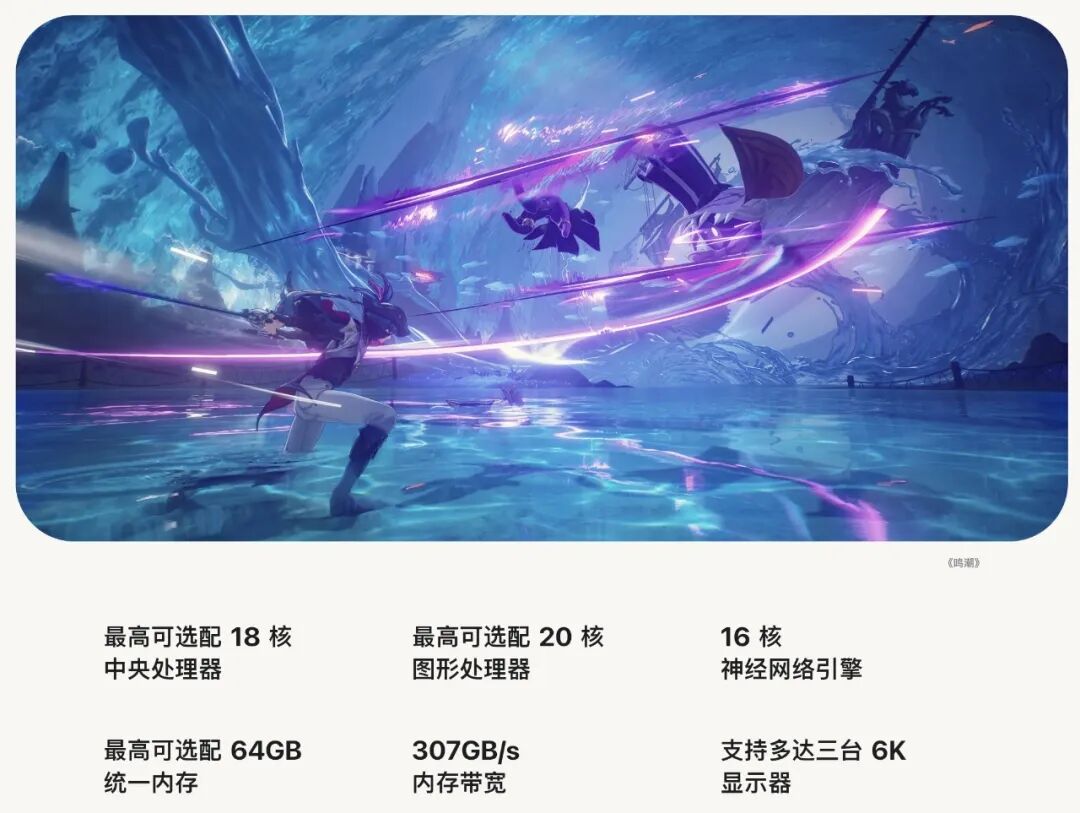
M6 是苹果第一颗 2nm 工艺的芯片,12 核 CPU,12 核 GPU。
CPU 这边有个新东西,苹果第一次在一颗主流 M 系列芯片里同时塞了三种核心,2 个超级核心、4 个性能核心、6 个能效核心。超级核心扛最重的活,性能核心处理多线程,能效核心管后台和轻量任务。最终结果是多线程性能比 M4 最高提高 40%。
对本地 AI 更关键的是 GPU 那部分。M6 第一次在 Mac mini 的 GPU 每一个核心里都加了神经网络加速器,还给它加上了 FP8 支持。同时神经网络引擎升级成两组 16 核。也就是说 CPU、GPU、神经网络引擎这三套东西同时被加强了,系统可以按任务类型分配负载。
苹果给的数字,M6 的 AI 计算性能比 M4 最高提高 4 倍,图形性能最高是 M4 的两倍。跟更老的机器比落差更大,搭载 M6 的 Mac mini 对比 M1 Mac mini,在 LM Studio 上跑大语言模型的提示词处理速度最高提升 13.5 倍。
内存带宽 170GB/s,比 M4 最高提高 40%,统一内存最高支持到 32GB。
说到统一内存,这里得展开讲一句
这个概念对想在本地跑模型的同学特别重要,值得花两分钟弄明白。
传统 PC 里,显卡有自己的显存,系统有自己的内存,两边是分开的。你本地跑一个大模型的时候,模型参数得装进显卡能直接访问的那块显存里。所以哪怕你系统内存插到 128GB,显卡也不能把它当显存用,能跑多大的模型还是被显存卡着。
苹果的芯片不一样,CPU 和 GPU 共用同一个内存池,谁都能直接访问同一份数据,不用在两块内存之间来回搬。所以对本地跑模型来说,Mac 的统一内存有多大,基本就决定了它能装下多大的模型。
这带来一个挺有意思的变化。以前买电脑先问 CPU 几核、显卡多快,到了本地 AI 这件事上,问题变成了这台机器到底能装下多大的模型。