正在加载…
先看它做出来的东西
APPSO 拿这个新模型做了一份西藏自驾游的 PPT,商业定制那种规格。往下滑,这是完整的一份。
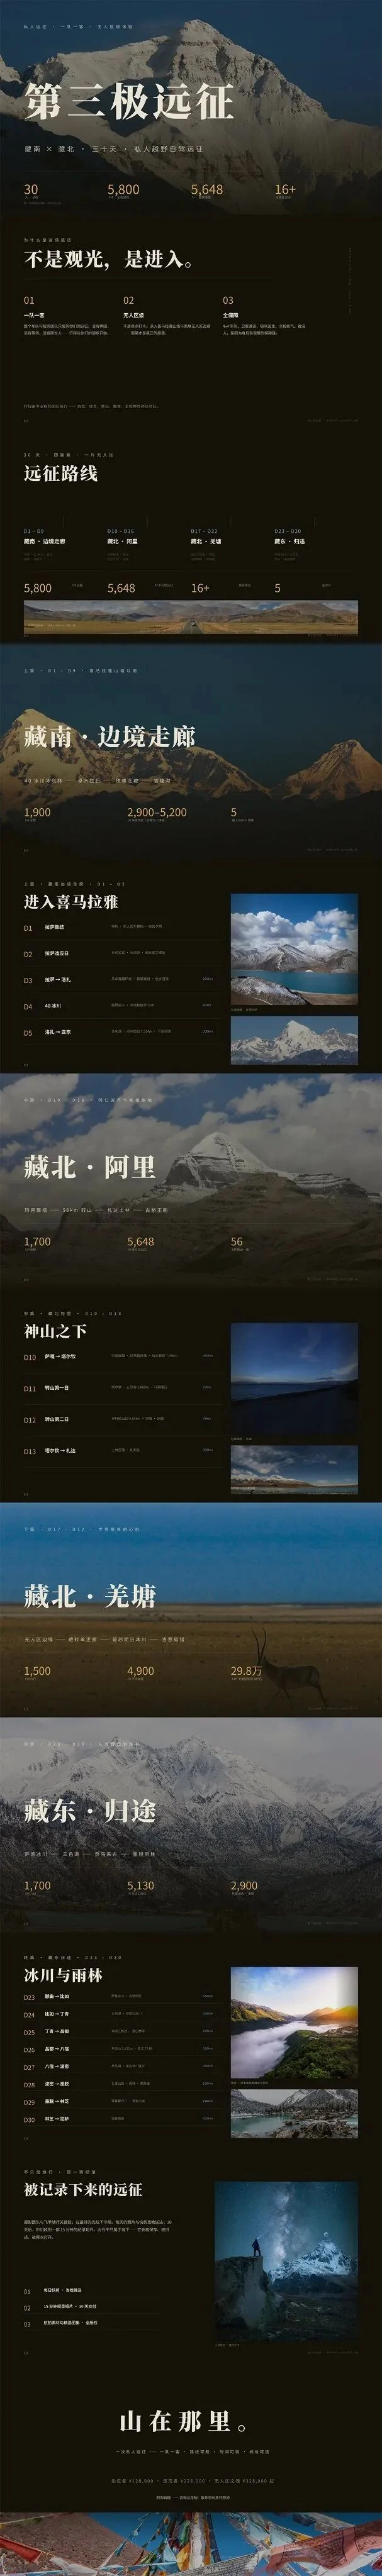
深色底、大图压字,30 天、5800 公里、5648 米海拔这些数字一路铺下来,从远征路线到藏南、藏北、藏东分段,最后落在「山在那里」。这是一次生成的一整份。
第二个例子我更喜欢。他们让它照着 DeepSeek Harness 的官网做二次创作。
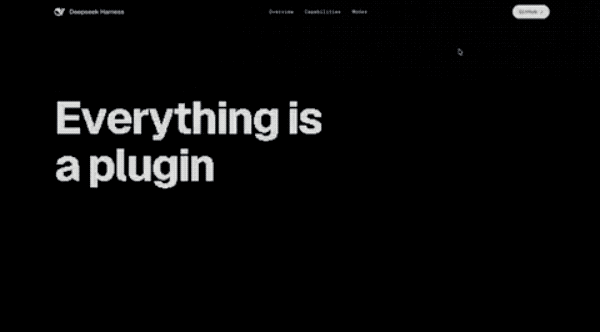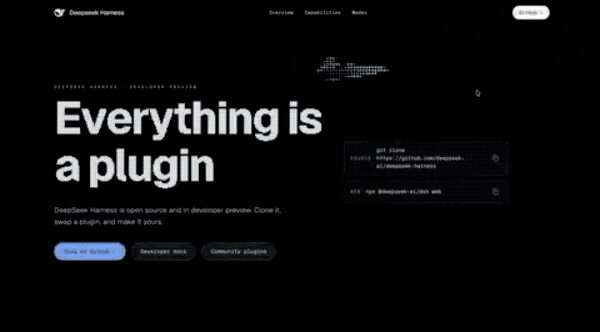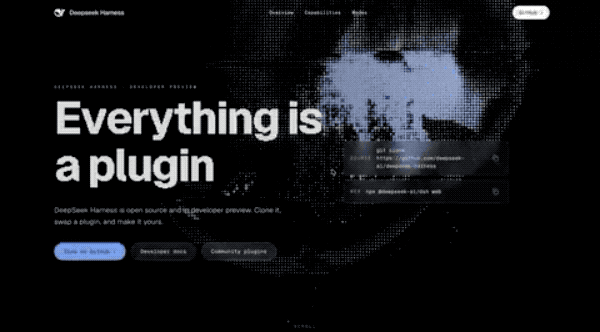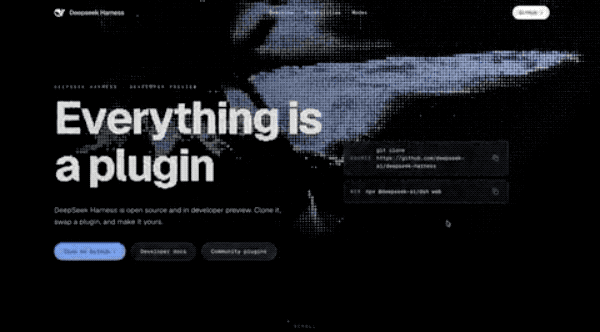
你给模型看一个网页长什么样,它就能照着这个感觉做出新的来。第四周我们讲做网站的时候,最难的一步是把你脑子里想要的样子描述给 AI 听。现在你看到喜欢的页面,截个图给它就行了。
这两样东西是怎么出来的
看到这儿你八成会有个疑问,说好的「会看图」,怎么直接做出一整份 PPT 来了,这不就是画图吗。
这里有个链条,值得花两分钟弄明白,因为它决定了你该对这个模型抱什么预期。
一份 PPT 从 AI 手里出来,是这么走的。你把西藏那些照片素材交给它,它先看懂每一张是什么,哪张是雪山、哪张是藏羚羊、哪张是经幡。接着它写出一份很细的施工图,第几页放什么标题、配哪段文字、什么颜色、哪张照片摆在哪个位置,全都写明白。最后由软件照着这份施工图渲染成你看到的成品。
模型从头到尾输出的都是文字,那份施工图就是文字。成品里的照片,还是你交给它的原图,它一张也没画。
新增的看图本事,管的是这条链子的第一步。以前那个纯文本的 DeepSeek 看不见你给的素材,不知道哪张是雪山哪张是羚羊,也就没法决定哪张放哪儿、配什么话。现在它看得见了,这份 PPT 才做得成。
第二个例子是同一个道理。给它看官网截图,它看懂了版式,然后写出新的网页代码,浏览器渲染出来就是你看到的那个页面。
所以「用这个模型生成 PPT」这个说法没毛病,它生成的是版面、文案和结构。让它凭空给你画一张雪山出来,那是另一类工具的活。
顺带说清楚,DeepSeek 现在不能生图
它的输入可以是文字加图片,输出只有文字。DeepSeek 现在 API 上挂着三个模型,没有一个能生图,官方文档里也没有文生图这个接口。
DeepSeek 早先开源过一个能画图的模型,叫 Janus-Pro,2025 年 1 月放出来的。但那是开源的模型权重,得自己找机器部署,App 里没有,API 上也没有,普通人基本碰不到。
要画图还是得另外找工具,课上提过的即梦、可灵都能干这活。前两天讲 PPT Master 那篇我说过,配图对整份 PPT 的观感影响很大,说的是同一件事,看图的和画图的得分开配。
这些活你可以交给它了
官方给的方向是三块,办公、开发、内容生产。我把它翻译成你手上具体的活。
办公这块,会议白板拍下来让它整理成纪要,发票、快递单、菜单拍照丢给它转成表格,PDF 里那页看不懂的图表截下来问它数据在说什么。
开发这块,报错截图直接丢过去,不用再一个字一个字敲进去。页面哪里排歪了,截个图跟它说这里不对。
内容这块,看到一张喜欢的封面或者版式,截图给它,让它讲清楚这版式好在哪、换成你的内容该怎么排。手写的笔记拍照,让它录成文字,直接进你的 Obsidian。
今天就能试,三条路
一、什么都不用配
直接开 DeepSeek 网页版或者 App,用识图模式传图就问。这条 6 月就通了。想先感受一下它眼力如何,从这儿开始最快。
看到这儿,后面是学员专属
后面这一半是训练营学员的内容。你要是学员,用手机号登录就能接着往下看。