正在加载…
先说 DeepSeek V4 Pro:它到底强在哪
这次发布的是正式版,DeepSeek 官方给的编号是 V4-Pro-0813。之前四月份出过一个预览版,很多人试过觉得一般,这次是脱胎换骨。
先看官方自己放出来的跑分表:
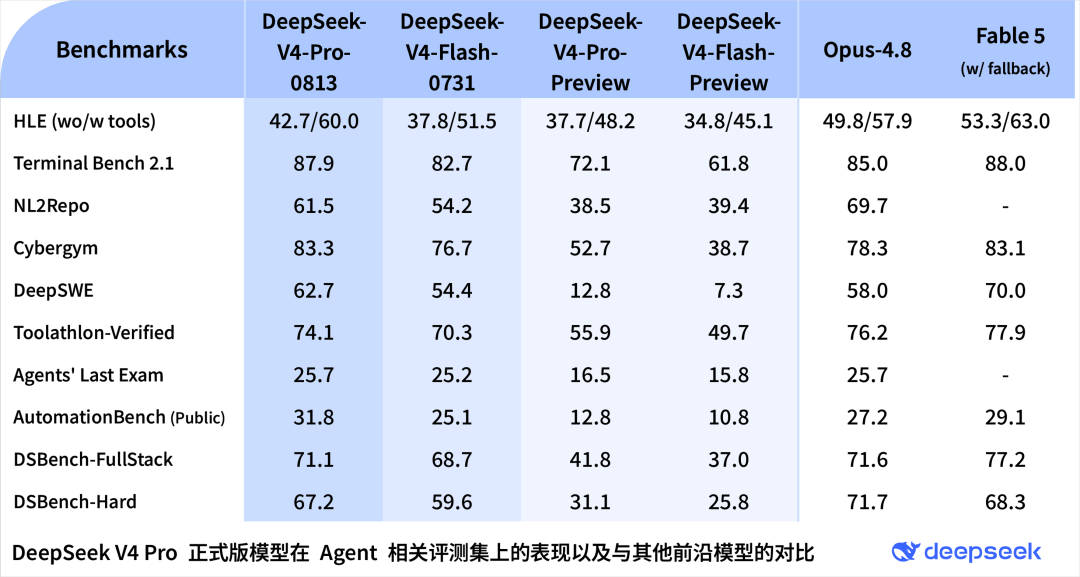
这张表列了一堆评测集,名字看着都头大。我挑两个最能说明问题的,用大白话解释一下它们在考什么。
第一个叫 Terminal Bench。你可以把它理解成:把模型直接扔进电脑的命令行里,让它自己装环境、敲命令、遇到报错自己想办法,最后真把活干完。这考的是「能不能独立干成一件事」,跟咱们平时让 CodeX 自己跑任务是一回事。
这一项,V4 Pro 正式版考了 87.9 分。预览版是 72.1,一次涨了 15 分。Claude 那边最强的 Fable 5 是 88.0 分,Opus 4.8 是 85.0 分。
差 Fable 5 零点一分,反超了 Opus 4.8。
第二个叫 DeepSWE,考的是更接近真实的软件开发:读懂一整个代码项目,然后处理里面复杂的工程问题。V4 Pro 考了 62.7,预览版只有 12.8。Fable 5 是 70.0,Opus 4.8 是 58.0。
这项它还差 Fable 5 一截,但同样超过了 Opus 4.8。
表里另外几项也可以看看。网络安全那项(Cybergym)它 83.3 分,Fable 5 是 83.1,它反超了。数据科学的难题那项(DSBench-Hard)它 67.2,Fable 5 是 68.3,几乎咬住。
给它工具、让它动手操作,DeepSeek V4 Pro 已经挤进第一梯队了。不给工具、光靠它肚子里的知识和推理,跟 Fable 5 还差十几分。
跑分是抽象的,它实际能干出什么活
今早爱范儿也发了一篇实测。他们用的工具正好是咱们熟悉的 WorkBuddy,做的也是普通人能看懂的活,比跑分好懂。
第一个任务,他们让它从「微信读书 Skill」里读出八月的读书数据,做成一个 HTML 数据报表。
这活儿不难。有意思的是它多做的一步:它跑去翻了文件库里另一个跟这次任务无关的「爱范儿设计规范 Skill」,按那套规范给报表配上了公司的专属配色。
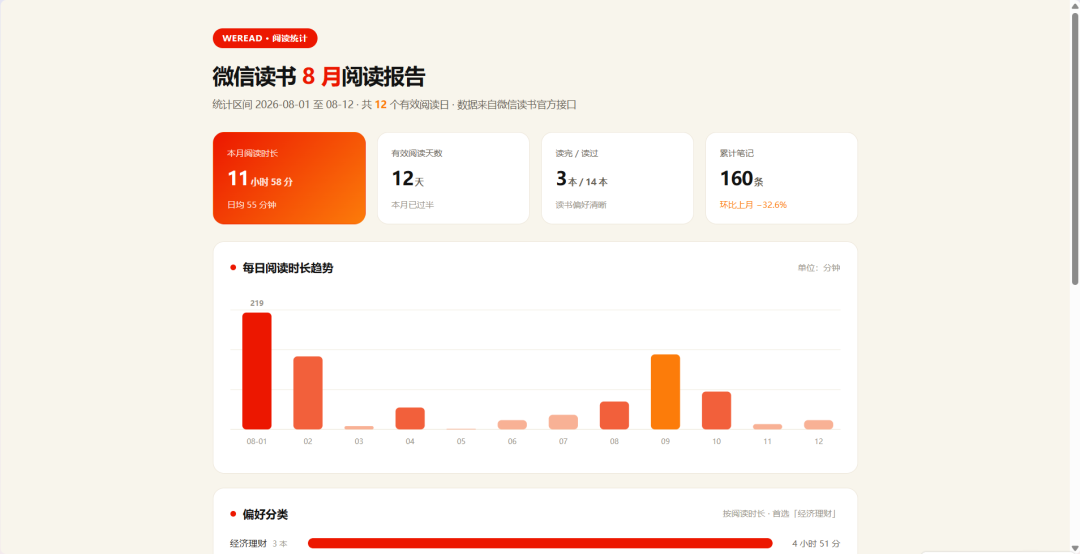
没人告诉它要这么干。正在搞 Skill 大赛的同学可以记一下这件事:Skill 不光是被动等着被调用,模型够聪明的时候,它会自己判断该把哪几个凑起来用。
再往后,他们让它做一个新闻网站首页,提示词写得相当模糊,没规定版式,没规定风格。它自己搜了近期真实的科技新闻,模仿传统媒体做了衬线字体的版式,还「手绘」了一张配图。
还有俄罗斯方块和一个模拟鸟群飞行的互动组件,方块带了点伪 3D 的效果:
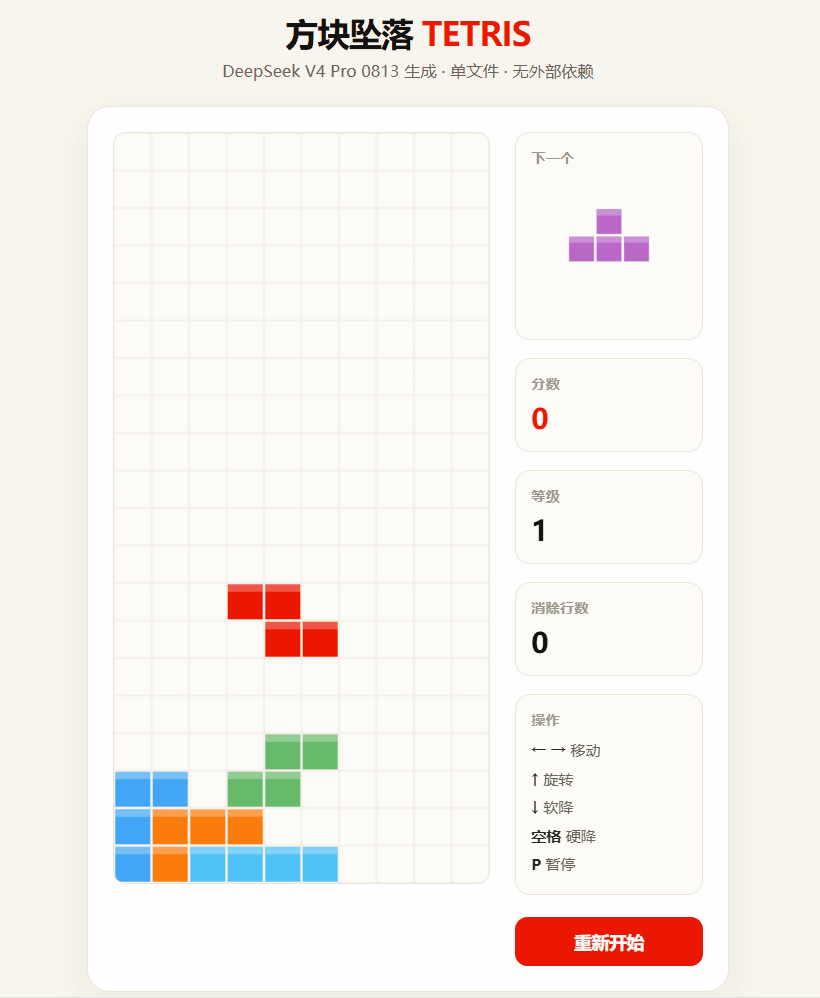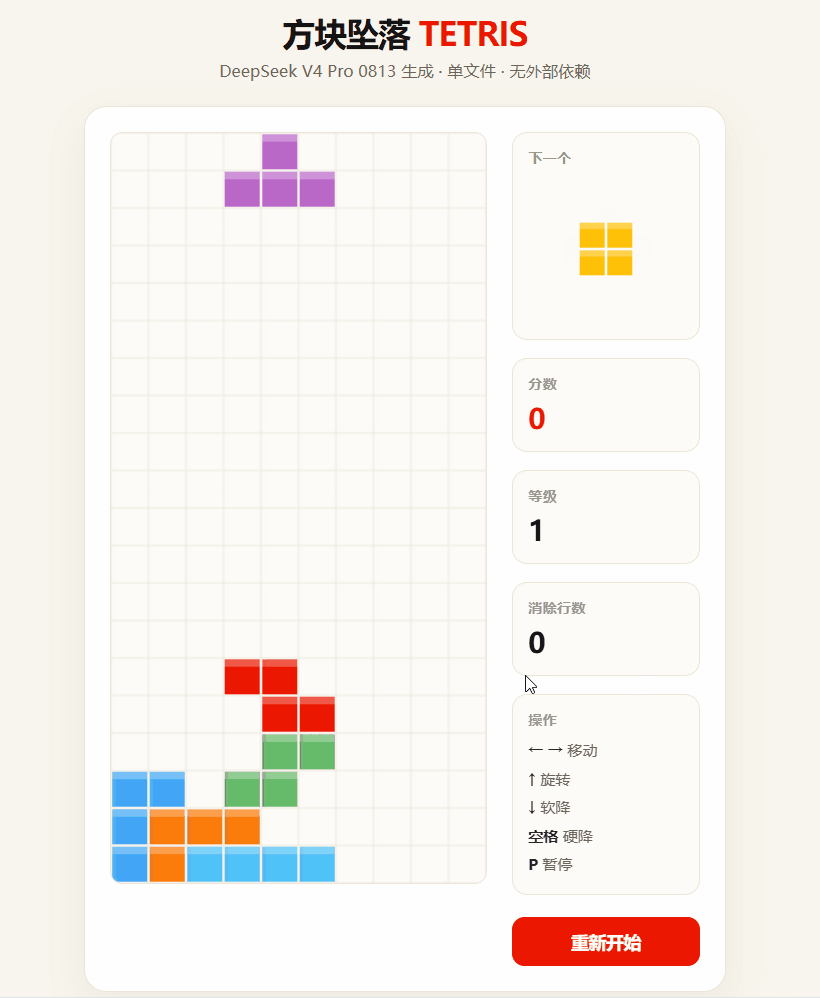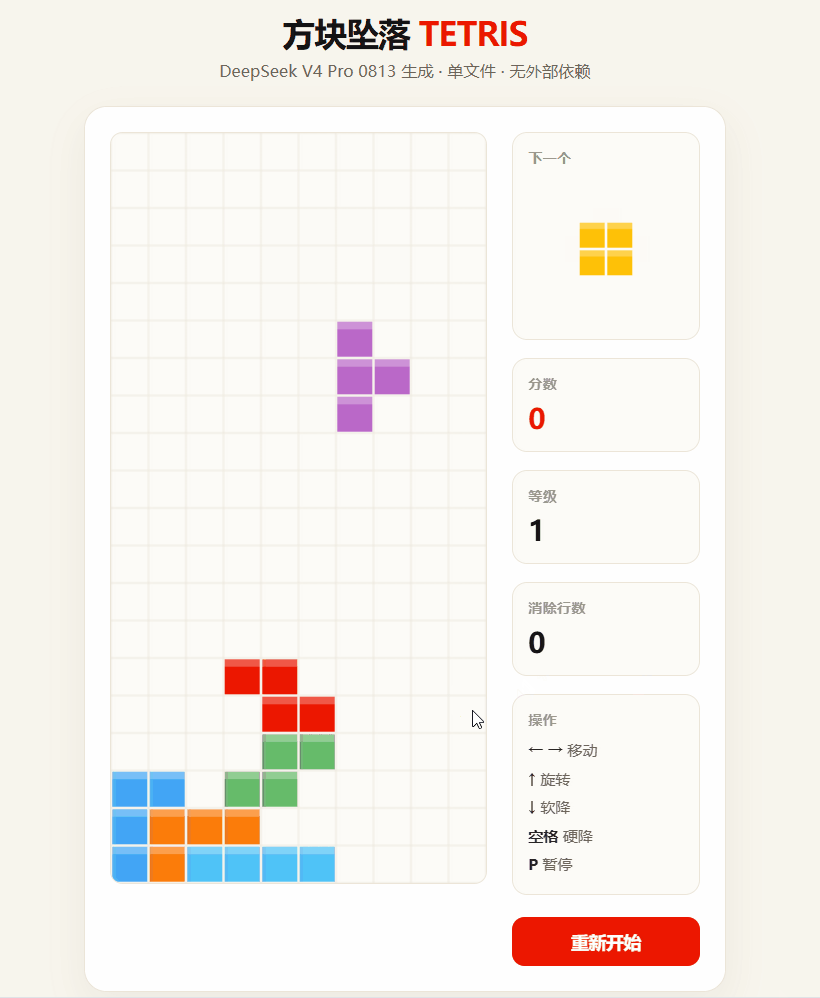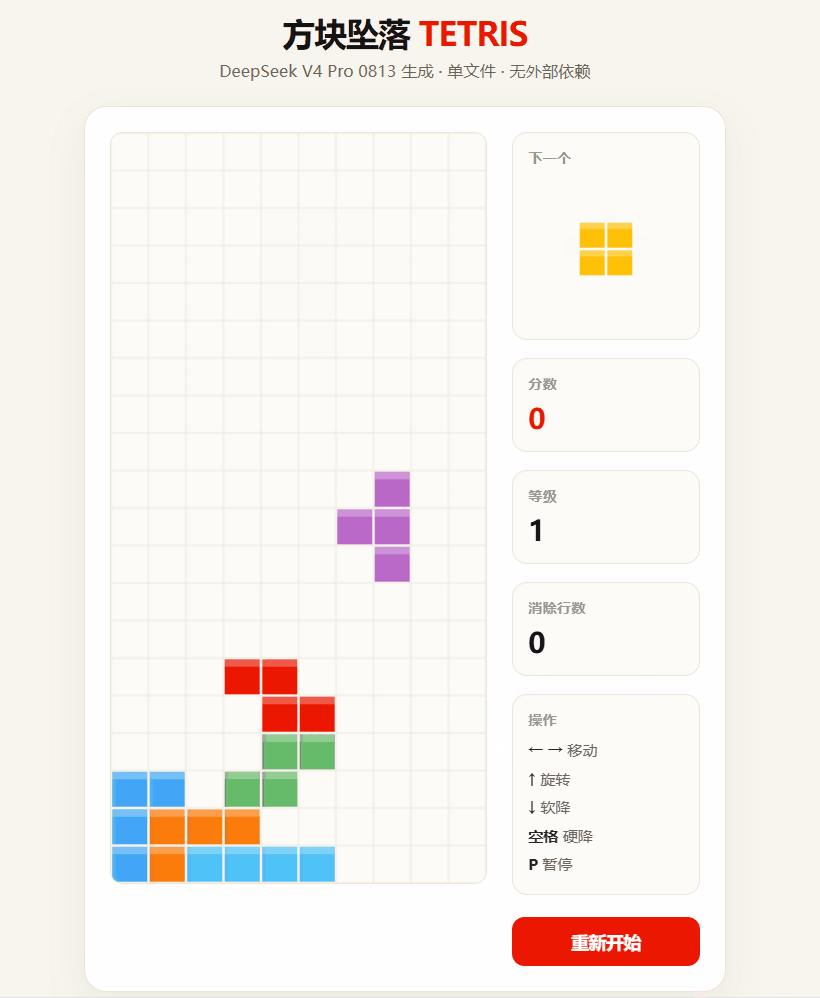
布置这几个任务的时候,作者只跟它说了一句「我要去睡觉」。做什么方向、怎么实现,全是模型自己掂量的。
这句话比跑分更能说明「Agent 能力」是什么意思。你给个大概方向,它把模糊的要求拆成清楚的需求,自己规划,分步做完。
它便宜到什么程度
我去 DeepSeek 官方定价页核对了当前价格,直接说人民币,按每百万 Token 算(一百万 Token 大概相当于一两百万汉字):
输入,缓存没命中 3 元,缓存命中只要 0.025 元。输出 6 元。
让它吐出一百万字的东西,六块钱。
Claude 那边的 Fable 5 是输入 10 美元、输出 50 美元。输出这一项,DeepSeek 便宜了大约 57 倍。缓存命中的输入差了将近 300 倍。
这里插一句「缓存命中」是什么意思,之前的精选里也讲过:同一场对话里,你每次提问都会自动带上前面的聊天记录,这些「旧内容」它刚处理过、还热乎着,不用重新算一遍,所以收费极低。跟 AI 聊得越久,旧内容占比越高,平均下来越便宜。
一个 Agent 能力接近顶尖的模型,跑起来的成本只有对手的几十分之一。这个局面挺少见。
但它有三个短板,必须说清楚
第一个短板最要紧,它不支持多模态,说人话就是看不了图。
我把官方模型说明翻了一遍,视觉、音频、视频一个都没有。发布前有过「原生多模态」的传闻,最后没有兑现。
这对咱们的影响很具体:你想把一张报错截图丢给它看、让它帮你分析,不行;你想让它看着一张设计稿改网页,不行;你想让它读一份扫描版的 PDF,也不行。这些活儿它一概干不了。
第二个,速度一般。这一点卡兹克在文章里讲得很直白,他同时开着两边跑任务,Grok 那边跑完三个了,DeepSeek 这边一个还没跑完。这是他的实际体验,我照实转述。
第三个,涨价预告还悬在头上。我今天又去官方定价页看了一眼,那句话还挂着,说近期计划整体上调价格、预期涨幅较大。上面那些数字,都是「目前」的价格。
再说 Grok 4.6:它赢在速度
Grok 4.6 是 8 月 12 号发布的。先看 xAI 官方给的跑分:
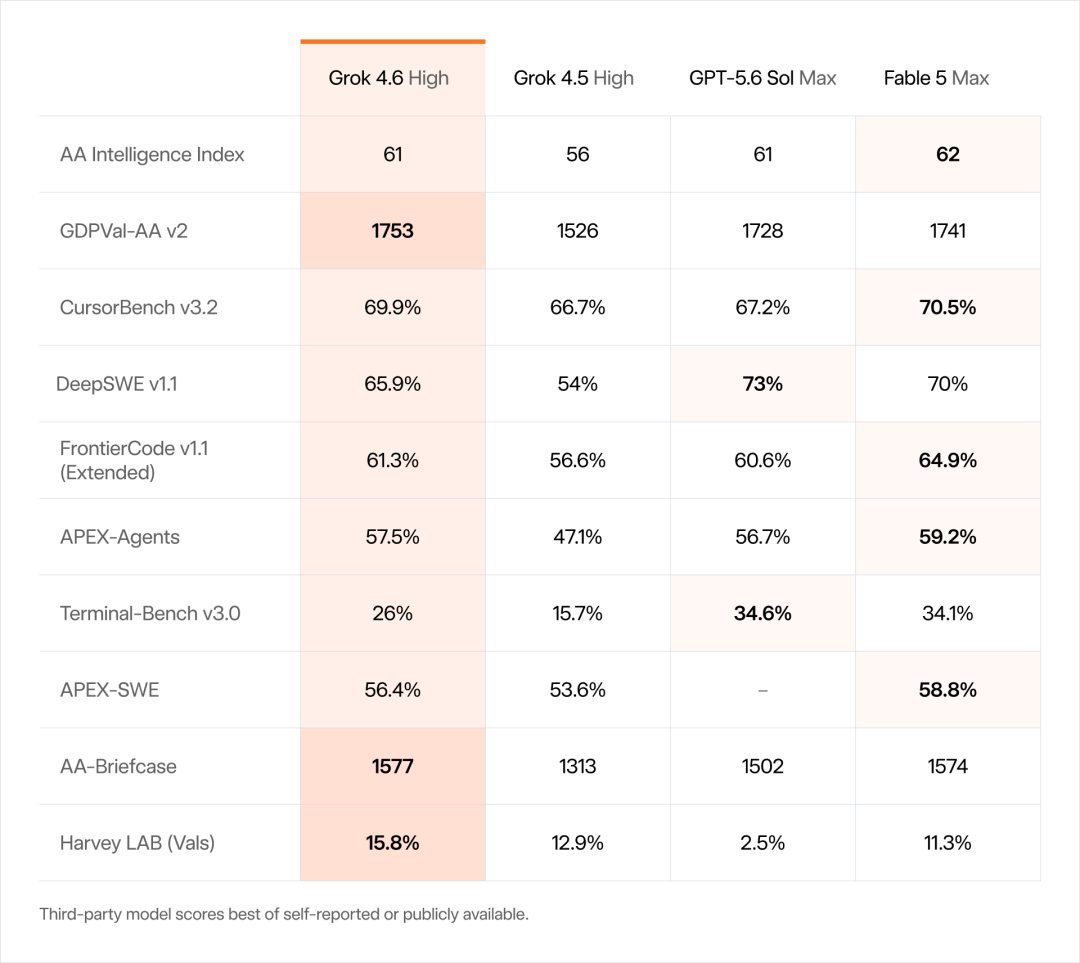
有个综合智力评分叫 AA Intelligence Index,Grok 4.6 是 61 分,上一代 Grok 4.5 是 56 分,GPT-5.6 Sol 是 61 分,Fable 5 是 62 分。基本追平了第一梯队。
有几项它是全场最高的:一个模拟真实经济活动价值的评测(GDPVal)它 1753 分,Fable 5 是 1741;一个考公文和商务处理的评测(AA-Briefcase)它 1577,Fable 5 是 1574;法律那项它 15.8%,其他家都在 12% 以下。
做财务模型、写报告、处理法律文书这类办公场景的活儿,它是真强。
短板也在表里明摆着。终端任务那一项(Terminal-Bench v3.0)它只有 26%,GPT-5.6 Sol 是 34.6%,Fable 5 是 34.1%。让它自己进命令行折腾环境,它比对手差一截。
别把这个 26% 跟前面 DeepSeek 那个 87.9 放一起比,那是两份不同版本的考卷(一个 v3.0 一个 2.1),难度不一样,比了没意义。
这张表是 xAI 自己发布的,脚注写明了对手的成绩取自公开数据。厂商自己的跑分表,看个趋势就好。
Grok 有条计费规则,不注意会多花钱
Grok 4.6 的上下文是 50 万 Token,价格是输入 2 美元、输出 6 美元。
但我在 xAI 官方文档里查到一条卡兹克文章里没提的规则:一旦你这次请求的内容超过 20 万 Token,价格全部翻倍,输入变 4 美元、输出变 12 美元。
注意是「全部」,不是超出的部分翻倍。
如果你习惯把一大堆资料一次性丢给它,或者一场对话聊得特别长,很可能在毫不知情的时候跨过那条线,账单翻一倍。用它处理长文档的同学留意一下。
它能看图,支持图像输入,单张最大 20MB,正好补上 DeepSeek 的缺口。
它的知识截止到 2026 年 2 月,问它更近的事情要让它联网。
看到这儿,后面是学员专属
后面这一半是训练营学员的内容。你要是学员,用手机号登录就能接着往下看。