正在加载…
它解决的是哪个具体的麻烦
把 PDF 转成文字,工具早就一堆了。但只要你真拿论文、财报、合同去试过,就知道它们在哪儿翻车。
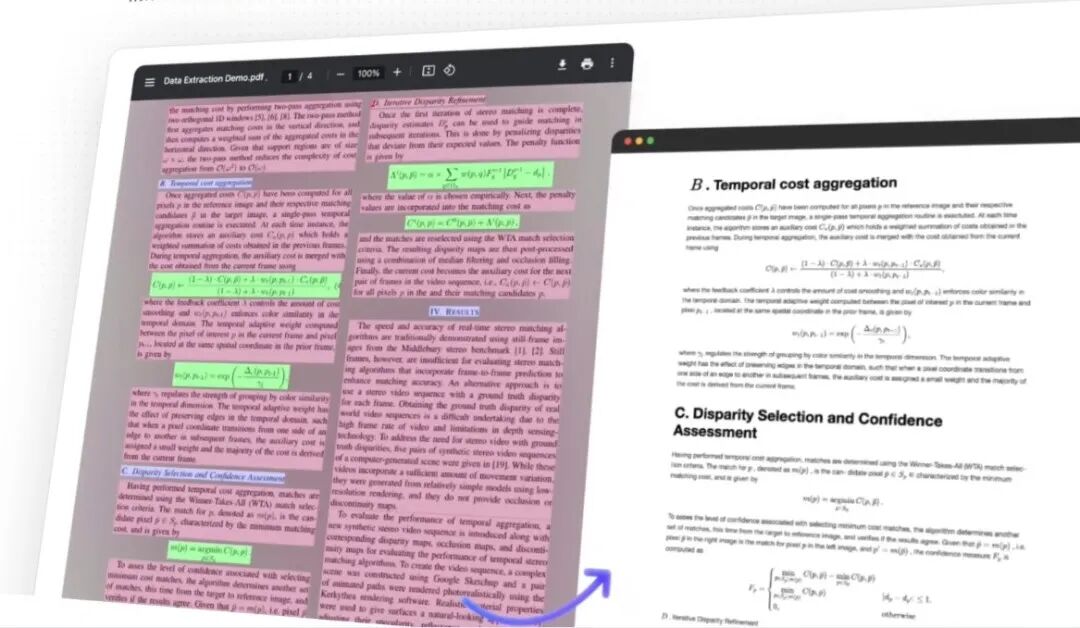
最常见的是双栏排版。学术论文、报纸、研究报告都爱用双栏,普通工具一读,从页面最左边一路读到最右边,左右两栏的句子全拼在一起,出来的东西根本没法看。
MinerU 会先分析页面布局,再按人眼真正的阅读顺序去提取。左边是原始的双栏论文,右边是它转出来的结果:
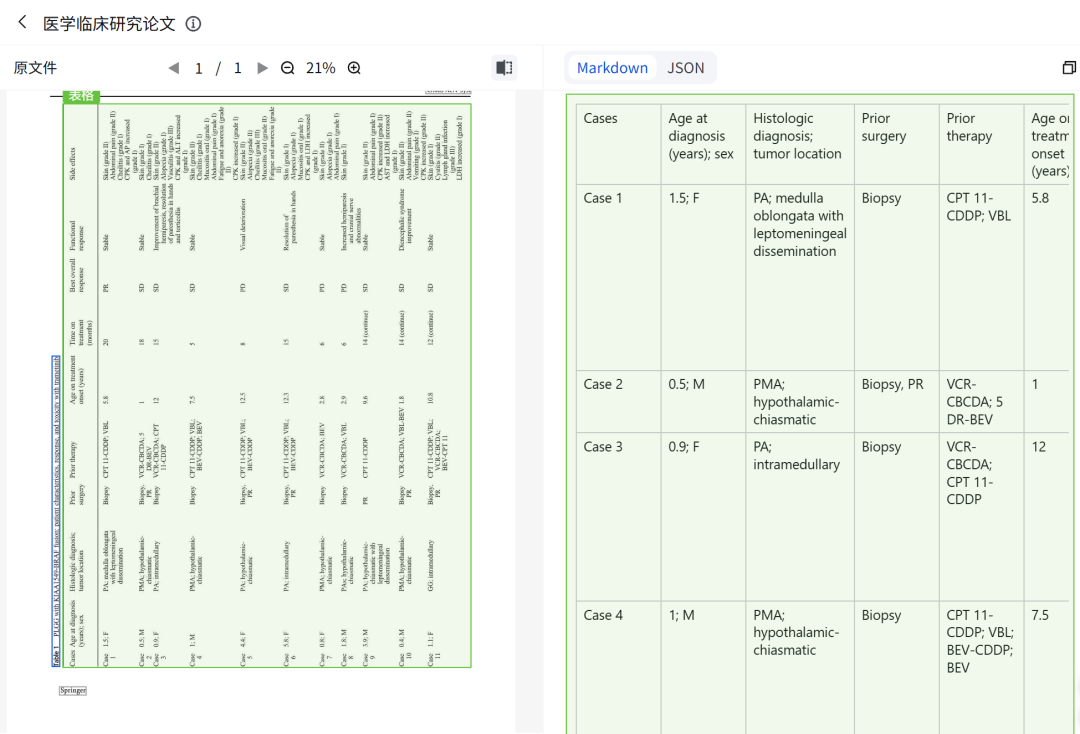
第二个是表格,这是 PDF 转换最容易崩的地方。合并单元格、多行表头、跨了三页的长表、甚至整张表是竖着印的,普通工具基本交白卷。
下面这张,左边是一张竖排的医学论文表格,右边是转出来的结果:
除了这两样,它还内置了 OCR,扫描件、老书、发票、拍下来的档案照片都能识别;论文里的公式会转成标准的 LaTeX 代码;输出会保留标题、正文、列表、图片、脚注这些层级,不是甩给你一整坨纯文本。
除了 PDF,图片、Word、PPT、Excel 它也能吃。转出来的东西是 Markdown 和 JSON 两种,前者你自己看、往知识库里放,后者给程序用。
它是上海人工智能实验室旗下 OpenDataLab 团队做的,目前 GitHub 上 7.7 万星。在 OmniDocBench 这个文档解析的公开评测里,它的成绩排在很前面。
怎么用:先说最省事的那条路
网上大部分教程一上来就教你装 Python、建虚拟环境、敲三条命令。那套流程没错,但对咱们大多数人来说根本不用走。
官网有打包好的客户端,下载装上就能用,Windows、苹果 M 芯片、Intel 芯片三个版本都有。
客户端在这儿:https://mineru.net/OpenSourceTools/Extractor
你只是想把手头几十份 PDF 转成 Markdown,客户端完全够用,拖进去就完事。
什么时候才需要装命令行版?两种情况:一是你要处理成百上千份文档、想写脚本自动跑;二是文件涉密,你希望全程连网都不联,所有处理都在自己电脑上完成。
想装命令行版的同学,官方的三条命令是这个:
pip install --upgrade pip
pip install uv
uv pip install -U "mineru[all]"
Python 装 3.10 到 3.13 之间的版本都行(Windows 是 3.10 到 3.12)。转一份文件也是一条命令,-p 后面跟文件,-o 后面跟输出目录:
mineru -p "论文.pdf" -o "output"
跑完打开 output 文件夹,Markdown、图片和相关文件都在里面。
它还支持批量,直接指定一个文件夹,让它一口气处理几百份。
看到这儿,后面是学员专属
后面这一半是训练营学员的内容。你要是学员,用手机号登录就能接着往下看。