正在加载…
先解释一个词:什么是 Harness
这是理解全文的钥匙,先用大白话说清。
模型(这里是 Seedance 2.5)就是那个真正会画视频的「引擎」。但引擎再强,你也得有方向盘、油门、导航,这些让引擎好用起来的一整套外壳,就叫 Harness(可以理解成「作业系统 / 干活的架子」)。
作者的原话很精辟:Seedance 2.5 支持一次投喂 50 个参考素材,但光整理素材你就得花半小时;它单次只能生成 30 秒,你想要 5 分钟怎么办?LibTV 就是那层 Harness,把模型的能力真正激活出来。 这跟咱们讲 CodeX、讲 Hermes 三层记忆是一回事:真正拉开差距的,从来不只是模型本身,而是你有没有一套让它满血干活的架子。
下面这五个玩法,全都是「Harness 帮模型补上短板」的具体例子。
玩法一:逐帧拉片,让 AI 把一段好视频拆给你学
你想拍打斗戏,但连提示词都不知道怎么写。作者的做法是:把《猛龙过江》李小龙对罗礼士的经典片段传上去,用「逐帧拉片」功能让 AI 自动拆解。
结果 AI 把 15 个分镜自动归成五组,每一帧都标好了镜头、机位和作用(「正反打」「特写对切·节奏放缓」),还拆出运镜切片和配乐。最绝的是它认出了导演在决战里安排了一只猫当「节奏呼吸点」,这种藏在专业导演脑子里的小心机,AI 自动分析出来了。
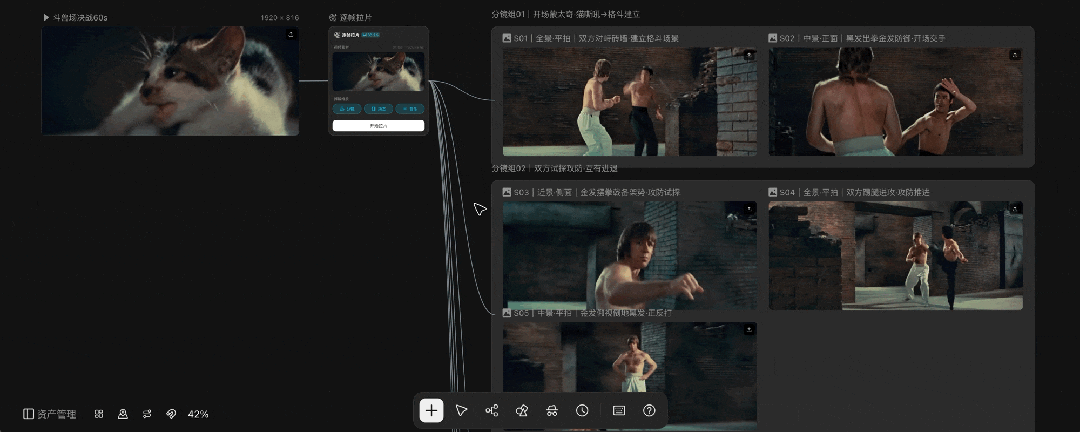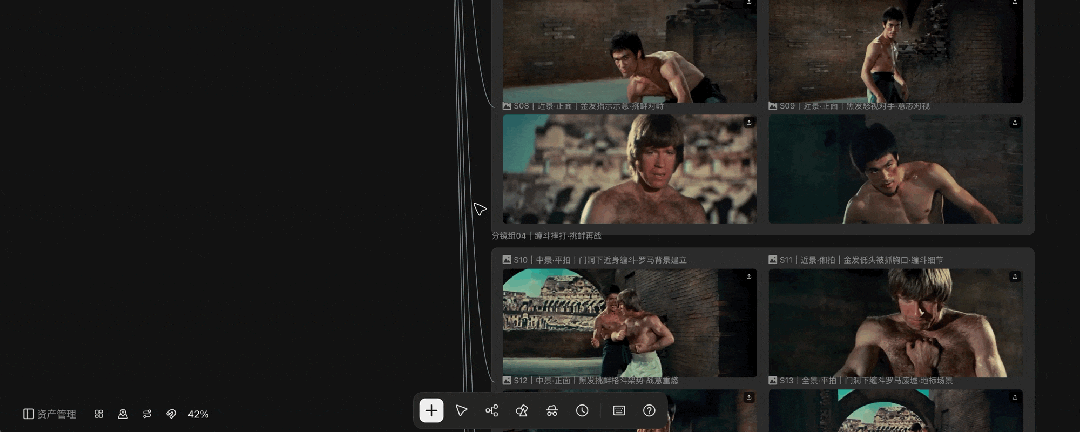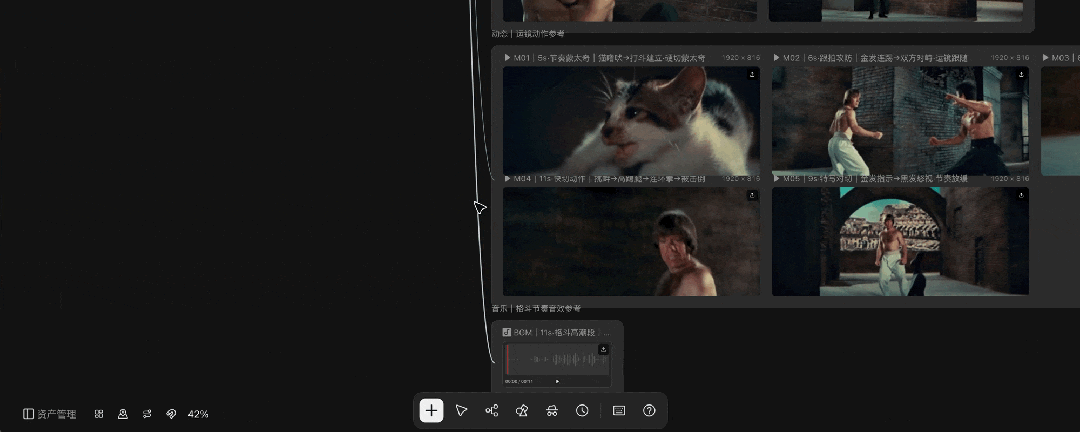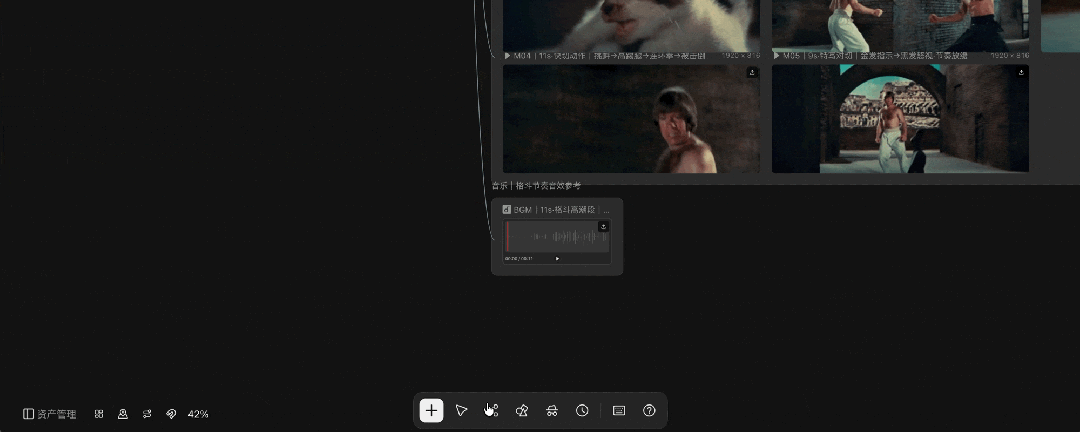
拆出来的素材可以直接拖去当参考。作者挂着这套「李小龙味儿」的参考,让自己剧里的角色打了一场,灵魂完全对上了。这一步不花钱,相当于白嫖了个武术指导。
玩法二:智能引用,20 多个素材,AI 自动对号入座
拍一部剧要先建「剧组」:作者用一句提示词批量生成了女捕快、白衣妖探、国师、妖面客等 20 多项定妆照。
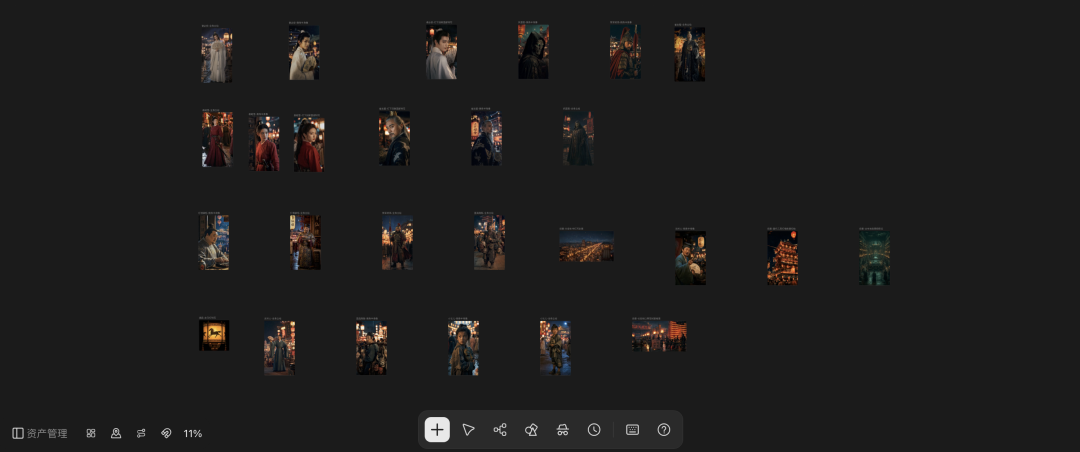
难点来了:Seedance 最多支持 50 个参考,以前你得挨个手动 @ 角色、场景、道具,「剧组还没开机人先麻了」。而「智能引用」这个功能,会让 AI 自动读懂剧本,判断哪句话该配哪个素材,一个个插到提示词的正确位置,你只需要确认。
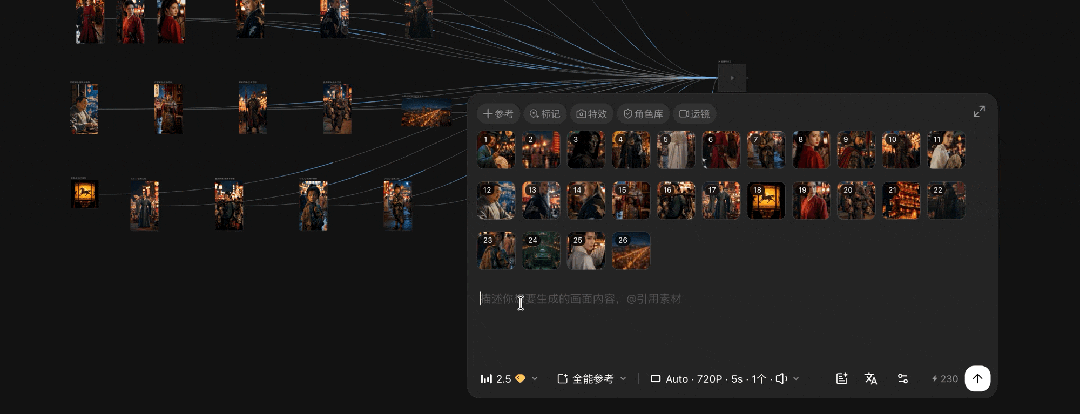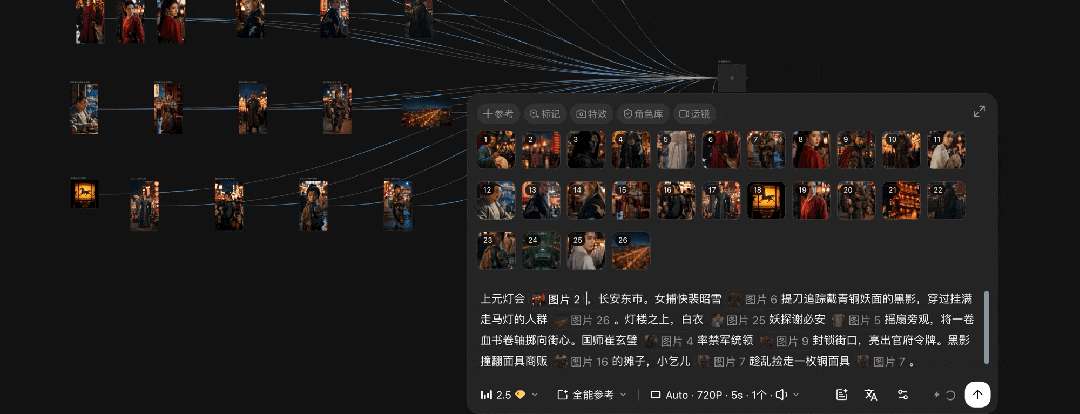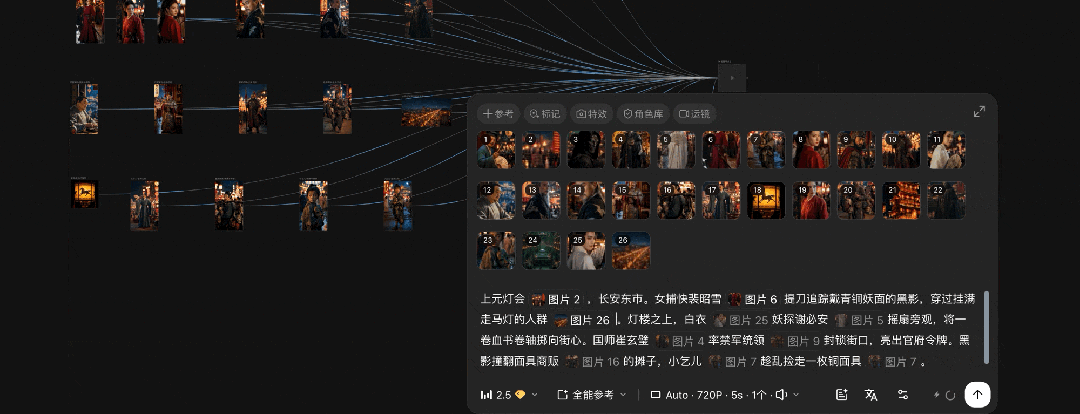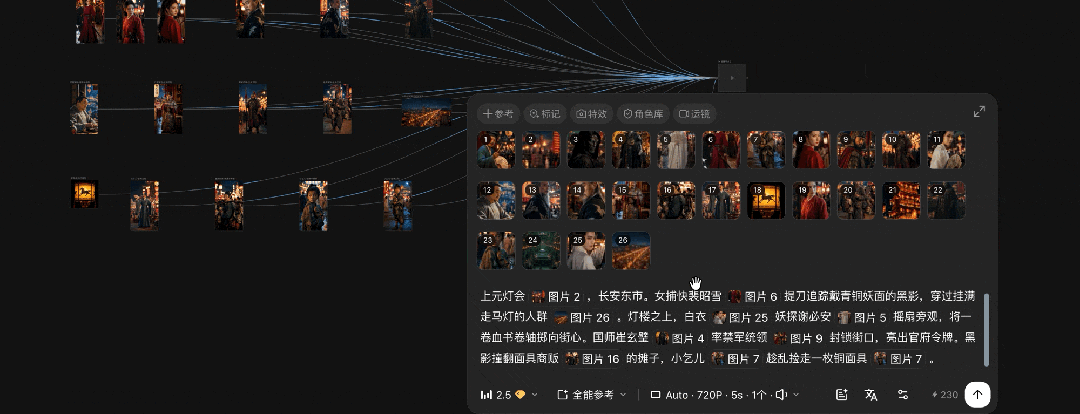
前后一分钟,20 多个素材引用全部搞定。这就是 Harness 在替你干最烦、最耗时的那段体力活。
看到这儿,后面是学员专属
后面这一半是训练营学员的内容。你要是学员,用手机号登录就能接着往下看。